Returnanalyse
Zur Einschätzung der Entwicklung von Portfolien oder Aktienkursen betrachtet man nicht die Aktienkurse selbst, sondern deren Renditen bzw. Returns. Hierzu gibt es verschiedene Definitionen, die teilweise nicht einheitlich verwendet werden. Daher wollen wir Beginn die verschiedenen Renditedefinitionen nochmals aufgreifen. Zunächst betrachten wir nur einzelne Werte, egal ob Aktien oder andere Finanzprodukte und bezeichnen den Kurs zum Zeitpunkt mit und uns interessiert die Wertentwicklung der Aktie vom Anfangszeitpunkt nach .
Rendite vs. Log-Returns
👉 Renditen beschreiben den prozentualer Wertzuwachs von nach :
und werden auch als diskrete oder arithmetische Returns bezeichnet. In der Finanzmathematik arbeitet man hingegen häufig mit den Log-Returns:
die teilweise auch als stetige oder geometrische Returns bezeichnet werden Wir werden gleich an einem realen Beispiel sehen, dass sich beide Renditebegriffe nur minimal unterscheiden, wobei mit
beide einfach ineinander umgerechnet werden können.
Das folgende Beispiel zeigt die Berechnung der täglichen Returns:
import yfinance as yf
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from datetime import datetime
import numpy as np

# Daten von Yahoo-Finance abrufen
ticker = "ALV.DE"
start_date = datetime(year = 2024, month=1, day = 1)


print("Versuche Yahoo Finance für %s:\n" % (ticker))
try:
    data = yf.download(ticker, start = start_date, group_by='ticker')
except Exception as e:
    print("Fehler bei Yahoo Daten Download: %s \n" % (e))

if not data.empty:
    data
    print(data.head())
    print(data.tail())
else:
    print("Probleme bey yfiancne Download von %s" % ticker)
Versuche Yahoo Finance für ALV.DE:
[*********************100%***********************] 1 of 1 completedTicker ALV.DE
Price Open High Low Close Volume
Date
2024-01-02 211.337756 214.600484 211.163747 213.121384 778095
2024-01-03 214.469986 215.122532 210.380703 211.033249 686416
2024-01-04 211.511789 213.599930 211.468283 213.599930 545050
2024-01-05 212.338357 213.164912 210.511224 212.207840 634842
2024-01-08 212.164337 213.121395 210.641730 212.773376 437610
Ticker ALV.DE
Price Open High Low Close Volume
Date
2026-09-11 442.399994 444.500000 440.600006 442.299988 297951
2026-09-14 442.299988 444.799988 440.200012 444.500000 321735
2026-09-15 443.200012 447.000000 440.399994 444.600006 0
2026-09-16 445.000000 449.299988 444.399994 449.200012 484992
2026-09-21 445.000000 445.100006 442.600006 443.100006 78813
df = data["ALV.DE"]
#Datum aus Index in Spalte holen:
#   nur zur Demonstration, ist hier nicht von Belang ob Date als Index oder Spalte!
df = df.reset_index()
df2 = df[["Date", "Close"]].copy()
print(df2.head())
Price Date Close
0 2024-01-02 213.121384
1 2024-01-03 211.033249
2 2024-01-04 213.599930
3 2024-01-05 212.207840
4 2024-01-08 212.773376
Verschiedene Methoden zur Berechnung beider Renditen:
df2["Rendite"] = df2["Close"].pct_change()
df2['LogReturn'] = np.log(df2['Close']).diff()   # = log(C_t) - log(C_{t-1})
#nur zum Vergleich alternative Berechnungsformeln, die natürlich identische Werte liefern!
df2['Rendite2'] = df2['Close'] / df2['Close'].shift(1) - 1
df2["LogReturn2"] = np.log(df2["Close"] / df2["Close"].shift(1))
df2["LogReturn3"] = np.log(df2['Rendite2'] +1)
print(df2.head())
Price       Date       Close   Rendite  LogReturn  Rendite2  LogReturn2  \
0     2024-01-02  213.121384       NaN        NaN       NaN         NaN
1     2024-01-03  211.033249 -0.009798  -0.009846 -0.009798   -0.009846
2     2024-01-04  213.599930  0.012162   0.012089  0.012162    0.012089
3     2024-01-05  212.207840 -0.006517  -0.006539 -0.006517   -0.006539
4     2024-01-08  212.773376  0.002665   0.002661  0.002665    0.002661

Price  LogReturn3
0             NaN
1       -0.009846
2        0.012089
3       -0.006539
4        0.002661
Offensichtlich sind die Spalten Rendite und Rendite2 sowie die drei verschieden berechneten Log-Returns gleich. Mittels plot() können wir den zeitlichen Verlauf darstellen. Da die Schlusskurse und die Renditen völlig verschiedene Wertebereiche haben, ist ein simpler Plot aller Zeitreihen nicht sinnvoll, so dass wir zuvor noch die Schluss-Kurse entfernen. Probieren Sie zum Vergleich einfach mal den folgenden Befehl:
df2.plot()<Axes: >
#Entfernen der Closing-Kurse
df3 = df2.drop(columns="Close").dropna().copy()
#Durch Indexierung des Datums steht dieses autoamtisch auf der x-Achse, sonst der Integer-Index 0,1,2,..
df3 = df3.set_index("Date")

#plot aller Renditen
print(df3.head())
df3.plot(ylim=(-0.05,0.05))
Price        Rendite  LogReturn  Rendite2  LogReturn2  LogReturn3
Date
2024-01-03 -0.009798  -0.009846 -0.009798   -0.009846   -0.009846
2024-01-04  0.012162   0.012089  0.012162    0.012089    0.012089
2024-01-05 -0.006517  -0.006539 -0.006517   -0.006539   -0.006539
2024-01-08  0.002665   0.002661  0.002665    0.002661    0.002661
2024-01-09 -0.004089  -0.004098 -0.004089   -0.004098   -0.004098
<Axes: xlabel='Date'>
Hinweis: die Pandas Methode pct_change() kann auch auf den kompletten DataFrame angewendet werden, solange das Datum als Index gesetzt ist. Dann werden die prozentualen Veränderungen auch für die Open, High und Low-Kurse berechnet. Ist das Datum allerdings als Spalte gesetzt, so führt der Aufruf zu einer Fehlermeldung, da die Funktion pct_change() nicht auf das Dates-Format angewendet werden kann. Außerdem werden die normalen Kurse überschrieben -- möchte man beispielsweise die Closing-Kurse im DataFrame erhalten, sollte wie oben in df2 einfach eine neue Variable / Spalte erzeugt werden.
Hinweis: Für die Berechnung der Renditen mittels der Pandas Funktion pct_change() ist es notwendig entweder eine konkrete Variable (Spalte) das DataFrames anzugeben, so wie das oben realisiert wurde. Ruft man mehrere Ticker gleichzeitig ab und möchte dann beispielsweise die Renditen auch gleichzeitig für alle Kurse berechnen, kann man andernfalls die Funktion pct_change() auch auf den gesamten DateFrame anwenden. Dann sollte man allerdings darauf achten, dass das Datum als Index gesetzt[1] ist. Natürlich ist es auch möglich, die Funktion nur auf eine Teilmenge aller Spalten bzw. Variablen anzuwenden.
data_all = data.pct_change()
data_all.head()Obiger Graph der verschieden berechneten Renditen zeigt, dass auch zwischen der klassichen Rendite als prozentuale Veränderung und den Log-Returns keine großartigen Unterschiede mit bloßen Auge erkennbar sind, denn für sehr kleine Zeitabstände (hier 1 Tag) ist der Quotient und somit die Unterschiede zwischen Log-Returns und Renditen nur marginal, was sich mit der Taylorapproximation 1. Ordnung der Funktion für nahe 1 erklären lässt. Berücksichtigt man höhere Ordnungen der Taylorapproximation wird deutlich, warum sich aber insbesondere für beide Return-Begriffe unterscheiden.
# x-Werte
x = np.linspace(0.01, 2, 400)     # für f(x) = ln(x), nur positive x

# Funktionen
f = np.log(x)
t = x - 1  #Taylor-Approximation 1. Oridnung

# Plot
plt.figure(figsize=(7,5))
plt.plot(x, f, label="f(x) = ln(x)", color="blue")
plt.plot(x, t, label="t(x) = x - 1", color="red")

# Achsen und Details
plt.axhline(0, color="black", linewidth=0.8)   # x-Achse
plt.axvline(0, color="black", linewidth=0.8)   # y-Achse
plt.title("f(x) = ln(x) und Taylorapproximation t(x) = x - 1")
plt.xlabel("x")
plt.ylabel("y")
plt.ylim([-2,1])
plt.legend()
plt.grid(True)
plt.show()
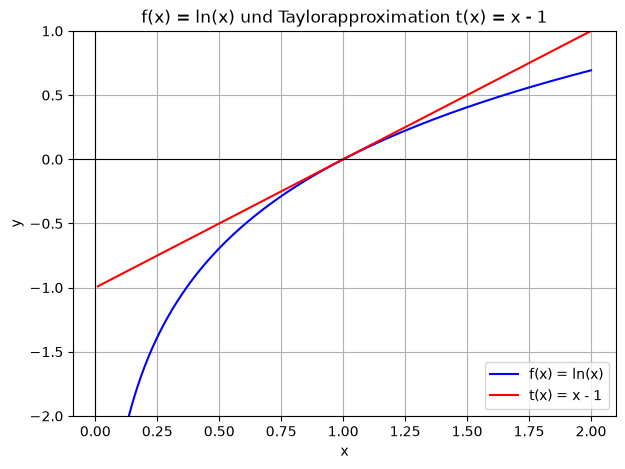
Es ist deutlich zu erkennen, dass für x nahe 1 kaum ein Unterschied zwischen beiden Funktionen zu erkennen ist. Zusammenfassend: Log-Returns und arithmetische Renditen unterscheiden sich für Tageskurse wegen
nur minimal, da die Kursänderungen von Tag zu Tag nicht wesentlich sind. Beide Rendite-Begriffe haben aus finanzmathematischer Sicht Vor- und Nachteile, die wir später nochmals kurz aufgreifen werden. Aus praktischer Sicht macht es hingegen kaum einen Unterschied, ob wir Renditen oder Log-Returns analysieren. Betrachtet man beispielsweise das Histogramm der täglichen Returns ist optisch kein wesentlicher Unterschied zwischen Log-Returns und Renditen erkennbar. Für Tagesrenditen bzw. -Returns schreibt man häufig bzw. , d. h. lässt den ersten Zeitindex des Anfangsstadiums einfach weg. Außerdem zeigt die Graphik, dass die rote Kurve, welche den prozentualen Zuwächsen und somit Renditen entspricht, immer oberhalb der blaue Kurve verläuft, welche die Log-Returns beschreibt.
Wertzuwachs über die Zeit: kumulierte Returns vs. Renditen
Die Log-Returns des Zuwachses von der Anfangsinvestition bis zum Zeitpunkt ist wegen
gerade die Summe der täglichen Log-Returns. Somit folgt dann für die Renditen eine Produkt-Struktur
also ähnlich wie beim (geometrischen) Verzinsen mit Zinseszinseffekten.
Zusammenfassend werden wir die kumulierten Tages-Returns von 0 bis zum Zeitpunkt t zur Annualisierung verwenden
bzw.
Die Funktionen cumsum() und cumprod() berechnen für jede Spalte die kumulierten Summen bzw. Produkte, d. h. in der ersten Zeile wird die nur das erste Element und in der zweiten Zeile die ersten beiden Werte usw. in die Summe bzw. das Produkt berücksichtigt. Somit kann die Entwicklung über die Zeit beginnend vom Startwert für beide Returnarten einach berechnet werden.
df3['LogReturns_kum']=df3['LogReturn'].cumsum()
df3['Rendite_kum']=(1+df3['Rendite']).cumprod()-1

print(df3.tail())

df3.LogReturns_kum.plot()
df3.Rendite_kum.plot()
plt.legend(['LogReturns','Rendite'])
Price Rendite LogReturn Rendite2 LogReturn2 LogReturn3 \
Date
2026-09-11 0.006371 0.006351 0.006371 0.006351 0.006351
2026-09-14 0.004974 0.004962 0.004974 0.004962 0.004962
2026-09-15 0.000225 0.000225 0.000225 0.000225 0.000225
2026-09-16 0.010346 0.010293 0.010346 0.010293 0.010293
2026-09-21 -0.013580 -0.013673 -0.013580 -0.013673 -0.013673
Price LogReturns_kum Rendite_kum
Date
2026-09-11 0.730126 1.075343
2026-09-14 0.735088 1.085666
2026-09-15 0.735313 1.086135
2026-09-16 0.745606 1.107719
2026-09-21 0.731934 1.079097

Es ist deutlich zu erkennen, dass für die frühen Zeitpunkte sich die Log-Returns und Renditen von 0 (also Jahresanfang 2024) bis kaum unterscheiden. Mit steigender Zeit laufen die beiden Renditekurven allerdings auseinander, da sich für größere Zeitabstände eben beide Returndefinitionen unterscheiden. Wie erwartet liegen die (kumulierten) Renditen immer oberhalb der Log-Returns
Annualisierte Returns
Aus Gleichung (8) folgt
d. h. die kumulierte Rendite von 0 nach t lässt sich basierend auf der modifizierten Stichprobe der Tages-Renditen mit Hilfe des geometrischen Mittels für
aller Tagesrenditen bis zum Zeitpunkt t ausdrücken. Ebenso können wir für die Log-Returns für die Stichprobe der Tages-Returns mittels des arithmetischen Mittels wegen Formel (7) schreiben als
Außerdem gilt folgender Zusammenhang zwischen geometrischen Mittel der Renditen und arithmetischen Mittel der Log-Returns für beliebige Stichprobengröße
Somit wird aus allen vorhanden Tages-Returns das jeweilige arithmetische und geometrische Mittel geschätzt und dann annualisiert man diese Werte entsprechend obiger Formeln, wobei man typischerweise unterstellt, dass ein Handelsjahr 252 Handelstage hat
sowie
Insbesondere für statistische Analysen werden häufig die Maßzahlen für jährliche Renditen angegeben, um eine bessere Vergleichbarkeit zwischen verschiedenen Anlageprodukten und Anlagezeiträumen durch die entsprechende Skalierung zu erreichen.
In Abschnitt Portfolioanalyse: erwarteter Portfolio-Return und Portfolio-Varianz benötigen wir die Erwartungswerte, Varianzen sowie Kovarianzen zwischen den einzelnen Aktienrenditen, um die erwartete Portfoliorendite und -Varianz zu berechnen. Für die Log-Returns ist dies aufgrund der Linearität des Erwartungswertes sehr einfach. Aus diesem Grund arbeitet man in der Finanzmathematik auch häufig lieber mit den Log-Returns als den Renditen. Unterstellt man, dass die Tages-Returns der -ten Aktie unabhängig und identisch verteilte Zufallsvariablen (iid) mit und sind, folgt für die erwarteten Jahres-Log-Returns sowie deren Varianzen bzw. Volatilitäten / Standardabweichungen
Zur Annualisierung der Kovarianz der täglichen Log-Returns führen wir folgende Bezeichnung ein: sei der zufällige Tages-Return der -ten Aktie von Tag -ten Tag zum -ten Tag und für die -te Aktie sei der Tages-Return vom -ten Tag zum -ten Tag, d. h.
Mit (7) folgt daher für die Jahres-Returns (für )
Unterstellen wir zusätzlich zur Standardannahme (tägliche Returns einer Aktie sind identisch und unabhängig verteilt, d.h. iid sowie iid), dass ausschließlich die Tages-Returns zweier verschiedener Aktien am selben Tag korrelieren, also genauer
erhalten wir für die Kovarianz der Jahres-Returns zwischen der -ten und -ten Aktie wegen
dass die Kovarianzen der Returns von 0 bis t einfach mit der Zeit skalieren
und somit die annualisierte Kovarianzmatrix aller Returns unter der Annahme dass ein Jahr 252 Handelstage besitzt
wobei die Kovarianzmatrix der Tages-Returns bezeichnet.
Die Annualisierung für die prozentualen Zuwächse ist wegen der Nichtlinearität in (9) bzw. (7) komplizierter, aber unter den obigen Annahmen der Unabhängigkeit der Tages-Renditen verschiedener Tage faktorisiert der Erwartungswert des Produktes. Analog zu den Log-Returns führen wir für die zufälligen Renditen folgende Bezeichnungen ein
wobei analog zu den Log-Returns und sowie
Aus Formel (8) bzw. (9) folgt dann für die erwartete Jahres-Rendite
zusammengefasst also
und die Varianz skaliert wegen
aus den Tageswerten
Insbesondere die Skalierung der Varianz für die annualisierten Renditen ist demnach also deutlich komplexer und insbesondere auch nichtlinear in der Zeit . Für die Kovarianzen der Jahres-Renditen zwischen der -ten und -ten Aktie ergibt sich bei analogen Annahmen zu den Log-Returns
denn
wobei die letzte Gleichung aus
folgt. Prinzipiell können wir also aus mit Formel (15) von den täglichen Erwartungswertvektor bzw. Kovarianzmatrix der Renditen übergehen zu den annualisierten Werten, allerdings nicht so einfach wie für die Log-Returns.
Statistische Analyse der Returns
Wie oben gesehen sind die Unterschiede zwischen täglichen Log-Returns und Renditen nicht wesentlich. So sehen die Histogrammen, die die Verteilung der täglichen Wertzuwächse wiedergeben sehr ähnlich aus, wie die folgenden beiden Graphiken zeigen. Der folgende Code erzeugt nicht nur ein klassisches Histogramm, sondern fügt noch den Standard-Kerndichteschätzer[2], was man einfach als empirische Dichtefunktion interpretieren kann, sondern auch noch zum Vergleich die angepasste Normalverteilungsdichte[3].
from scipy.stats import norm

#Parameter der NV aus Daten schaetzen
mu_log, std_log = norm.fit (df3.LogReturn)

#Alternative mit selben Schaetzwerten
#mu2 = np.mean(df3['LogReturn'])
#std2 = np.std(df3['LogReturn'])
#print("Schätzer mu=%f vs mu2 =%f" % (mu, mean))
#print("Schätzer std=%f vs std2 =%f" % (std, std2))

# x Werte fuer Dichteplot der Normalverteilung
x = np.linspace(min(df3['LogReturn']), max(df3['LogReturn']), 1000)

#Histogramm mit kernel
sns.histplot(df3['LogReturn'], stat = 'density', kde=True)

#Dichte = pdf mit gefitteten Parametern
y = norm.pdf(x, mu_log, std_log)

#hinzufügen der Dichte zum Histogramm:
plt.plot(x, y, color='red')
#Legende hinzufügen
plt.legend(['Kerndichteschätzer','Normaldichte'])
#Analoges Vorgehen für Renditen
mu, std = norm.fit (df3.Rendite)
x = np.linspace(min(df3['Rendite']), max(df3['Rendite']), 1000)
sns.histplot(df3['Rendite'], stat = 'density', kde=True)
y = norm.pdf(x, mu, std)
plt.plot(x, y, color='red')
plt.legend(['Kerndichteschätzer','Normaldichte'])
Der Kerndichteschätzer zeigt eine typische glockenförmige Verteilung. Allerdings zeigt der Vergleich zwischen Kerndichteschätzer und Normalverteilungsdichte eine recht deutlichte Abweichung zur Normalverteilung. In den Rändern der empirischen Verteilung liegen deutlich mehr Werte als bei der Normalverteilung üblich. Insbesondere die linke Seite, die starke Verluste repräsentiert, ist stärker ausgeprägt und dies spricht für eine leptokurtsiche Verteilung. Mit Hilfe der 3. und 4. Momente werden wir dies auch mit Hilfe statistischer Maßzahlen in höhere Momente: Schiefe und Kurtosis ausdrücken.
print("mittlere Tages-Rendite: %f Tages-LogReturns: %f" % (mu, mu_log))
print("Standardabweichung Tages-Rendite: %f Tages-LogReturns: %f" % (std, std_log))
mittlere Tages-Rendite: 0.001127 Tages-LogReturns: 0.001064
Standardabweichung Tages-Rendite: 0.011182 Tages-LogReturns: 0.011210
Oben haben wir bereits mittleren Tages-Returns und die Standardabweichungen berechnet. Allerdings kann man dies auch gleich spaltenweise für den gesamten DataFrame. Zu beachten gilt hier natürlich, ob die Maßzahl tatsächlich auch sinnvoll für jede Variable / Spalte ist. Die Mittelung der durchschnittlich kumilierten Returns ist beipspielsweise nicht sinnvoll, da für jede Zeile verschiedene Zeitpunkte betrachtet werden und somit keine stationäre Zeitreihe mehr vorliegt. Daher sollten die letzten beiden Spalten bei der Interpretation ausgelassen (oder noch besser ausgeblendet) werden, wie wir im Folgenden noch demonstrieren.
df3.mean()Price
Rendite 0.001127
LogReturn 0.001064
Rendite2 0.001127
LogReturn2 0.001064
LogReturn3 0.001064
LogReturns_kum 0.363292
Rendite_kum 0.468481
dtype: float64df3.std()Price
Rendite 0.011190
LogReturn 0.011218
Rendite2 0.011190
LogReturn2 0.011218
LogReturn3 0.011218
LogReturns_kum 0.206052
Rendite_kum 0.298060
dtype: float64Die describe() Funktion liefert eine Übersicht der wichtigsten Statistik-Maßzahlen
df3.describe()Mittels apply() können auch einzelne oder mehrere Funktionen auf die Spalten (axis = 0) bzw. Zeilen (axis=1) angewendet werden
df3.apply([np.mean, np.std], axis = 0)Natürlich können auch eigene Funktionen angewendet werden. Der folgende Code zeigt beispielhaft die selbstständige Berechnung der ersten beiden empirischen Momente:
def my_mean(x):
    return np.sum(x) / x.size

def my_var(x, correction = True):
    n = x.size
    m = my_mean(x)
    ss = ((x-m)**2).sum()
    df = n #biased variance estimator!
    if correction:
        #Bessel correction gives unbiased variance estimate
        df = df - 1
    return ss/df

def my_var2(x):
    n = x.size
    m = my_mean(x)
    ss = (x**2).sum() - n*m**2
    return ss/(n-1)

def my_var_biased(x):
    return my_var(x, correction=False)


def my_sd(x):
    return np.sqrt(my_var(x))

df3.apply([my_mean, my_var, my_var_biased, my_sd], axis = 0, correction = True)
Die Berechnung der statistischen Kennzahlen für die kumulierten Returns (letzten beiden Spalten) macht wie oben bereits erwähnt keinen Sinn, daher schließen wir sie einfach aus der Auswertung aus.
df3.drop(columns=["LogReturns_kum","Rendite_kum"]).apply([my_mean, my_var, my_var_biased, my_sd], axis = 0, correction = True)Alternativ kann man natürlich einfach die Variablen angeben, die man auswerten möchte: hier bietet sich neben der Funktion drop() auch die Pandas Funktion filter() an, bei der man beispielsweise mittels sogenannter Regular Expressions (siehe auch Regex Cheat Sheet) sehr vielfältige Bedingungen formulieren kann, siehe
Pandas Docu.
Im folgenden Code wollen wir alle Variablen die mit ‘Log’ beginnen (^Log) aber am Ende nicht auf ‘_kum’ enden (negative lookahead: (?!.*_kum$)) auswerten:
df3.filter(regex=r"^Log(?!.*_kum$)").apply([my_mean, my_var, my_var_biased, my_sd], axis = 0, correction = True)Hinweis: man kann das beliebig individualisieren. In manchen Auswertungen möchte man beispielsweise nur Variablen mit numerischen Werten auswerten, dann ist die Funktion select_dtypes() für die Auswahl bestimmer Datentypen hilfreich.
Ebenso kann die Funktion agg() wie die Funktion apply() angewendet werden:
df3.drop(columns=["LogReturns_kum","Rendite_kum"]).agg([my_mean, np.mean, my_var, my_var2, my_var_biased, my_sd, np.std])
höhere Momente: Schiefe und Kurtosis
Allgemein kann die Verteilung einer Stichprobe mittels der empirischen zentralen bzw. allgemeinen Momente
beschrieben werden. Während das 1. Moment den Mittelwert der Verteilung beschreibt, wird die Schwankung mittels des 2. Moments beschrieben und entspricht dem unkorrigierten Varianzschätzer
Die sogenannte Z-Transformation einer Stichprobe ist eine Standardisierung[^4] der Werte , so dass diese Stichprobe wegen um die Null schwankt mit Varianz
def my_central_moments(x,k):
    n = x.size
    m = x.sum()/n
    return ((x-m)**k).sum()/n

#2. Moment = Varianz
s2 = my_var(df3['LogReturn'])
s2_1 = my_central_moments(df3['LogReturn'], 2)
s2_2 = my_var_biased(df3['LogReturn'])

print("unbiased var = %f, 2. zentrales Moment = %f, biased var = %f" %  (s2,s2_1, s2_2))
unbiased var = 0.000126, 2. zentrales Moment = 0.000126, biased var = 0.000126
Mittels dem 3. Moment wird die (empirische) Schiefe einer Verteilung berechnet
Für symmetrische Verteilungen verschwindet die Schiefe (, ), während für linksschiefe (rechtssteil) Verteilungen der Wert negativ wird (, ) und für rechtsschiefe (linkssteil) Verteilungen (, ) sich ein postiver Wert ergibt.
def schiefe(x):
    m = x.sum()
    s = np.sqrt(my_central_moments(x,2))

    #s = x.std(ddof=0)   # Populations-Std für Normierung
    #n = x.size
    z = (x-m)/s
    return (my_central_moments(z,3))

#3. Moment / Schiefe
m3 = my_central_moments(df3['LogReturn'], 3)
g = schiefe(df3['LogReturn'])

print("Schiefe: g = %f basierend auf 3. zentralen Moment = %f" %  (g, m3))
Schiefe: g = -0.675736 basierend auf 3. zentralen Moment = -0.000001
Mittels 4. Moment misst man die Wölbung bzw. Krümmung einer Verteilung
wobei die Verschiebung um 3 für die bessere Interpretierbarkeit bzw. dem Vergleich zur Normalverteilung dient, denn diese Kennzahl vergleicht wie stark der zentrale Bereich und folglich auch wie schwach die ‘tails’ im Vergleich zur Normalverteilung besetzt sind. Werte von sind typisch für eine Normalverteilung, während positive Werte für eine spitzere Verteilung () mit mehr Maße in den Tails und negative Werte für eine breitere Verteilung () sprechen.
def woelbung(x):
    m = x.sum()
    s = np.sqrt(my_central_moments(x,2))

    #s = x.std(ddof=0)   # Populations-Std für Normierung
    #n = x.size
    z = (x-m)/s
    return (my_central_moments(z,4) - 3)

#4. Moment / Krümmung
m4 = my_central_moments(df3['LogReturn'], 4)
k = woelbung(df3['LogReturn'])

print("Kurtosis: gamma = %f basierend auf 4. zentralen Moment = %f" %  (k, m4))
Kurtosis: gamma = 3.189422 basierend auf 4. zentralen Moment = 0.000000
df3.drop(columns=["LogReturns_kum","Rendite_kum"]).agg([schiefe, woelbung])Natürlich gibt es auch enstprechende Pakete, um diese Kennzahlen einfach zu berechnen. Hier nutzen wir das Sub-Package scipy.stats
from scipy.stats import skew, kurtosis, moment

#g = schiefe(df3['LogReturn'])
#k = woelbung(df3['LogReturn'])
#Package Version:
g2 = skew(df3['LogReturn'])
k2 = kurtosis(df3['LogReturn'])
m3_sci = moment(df3['LogReturn'],  order=3)

print("Schiefe: g = %f, scipy.stats.skew  = %f" %  (g, g2 ))
print("3. Moment: m3 = %f, scipy.stats.moment = %f" % (m3, m3_sci))

print("Kurtosis: k = %f, Scipy.stats.kurtosis  = %f" %  (k, k2))

#kompletter DataFrame
print("Skew: %s" % df3.skew())

print("Kurtosis: %s" % df3.kurtosis())
Schiefe: g = -0.675736, scipy.stats.skew  = -0.675736
3. Moment: m3 = -0.000001, scipy.stats.moment = -0.000001
Kurtosis: k = 3.189422, Scipy.stats.kurtosis  = 3.189422
Skew: Price
Rendite          -0.598258
LogReturn        -0.677213
Rendite2         -0.598258
LogReturn2       -0.677213
LogReturn3       -0.677213
LogReturns_kum   -0.130098
Rendite_kum       0.185661
dtype: float64
Kurtosis: Price
Rendite           3.009662
LogReturn         3.221494
Rendite2          3.009662
LogReturn2        3.221494
LogReturn3        3.221494
LogReturns_kum   -1.025703
Rendite_kum      -0.824840
dtype: float64
Wir haben hier ausschließlich Tages-Returns ausgewertet, allerdings haben wir in Annualisierte Returns gesehen, wie wir diese zu Jahres-Returns skalieren können. Insbesondere Schiefe und Kurtosis sind im Gegensatz zu den zentrierten 3. bzw. 4. Momenten aber skalierungsfrei, da sich die Skalierungsfaktoren bei der Normierung herauskürzen.
Test auf Normalverteilung
from scipy import stats
test1 = stats.shapiro(df3['LogReturn'])
print(test1)
test2 = stats.normaltest(df3['LogReturn'])
print(test2)
ShapiroResult(statistic=np.float64(0.9603480674099475), pvalue=np.float64(1.115790129663665e-12))
NormaltestResult(statistic=np.float64(101.43499910392993), pvalue=np.float64(9.411737559761278e-23))
Abhängigkeiten zwischen Aktien-Returns: Kovarianz und Korrelation
Zur statistischen Auswertung zählt natürlich auch die Analyse der Abhängigkeiten zwischen verschiedenen Aktien. Im folgenden Abschnitt Portfolio-Returns werden wir aus verschiedenen Aktien ein Portfolio zusammenstellen und desen Entwicklung näher untersuchen. Bevor wir Portfolio-Returns studieren, untersuchen wir noch die Abhängigkeiten zwischen den einzelnen Aktien-Returns. Der Übersichtlichkeit wählen wir hier 4 Aktien und laden deren Kurse bei YahooFinance herunter:
tickers = ["AAPL", "MSFT", "GOOGL", "TSLA"]

# Kurse herunterladen (letztes Jahr)
portfolio_data = yf.download(tickers, period="5y")
#print(data.head())

#wollen nur Schlusskurse untersuchen
close_df = portfolio_data["Close"].copy()

print(close_df.head())
close_df.plot()
[ 0% ][**********************75%*********** ] 3 of 4 completed[*********************100%***********************] 4 of 4 completedTicker AAPL GOOGL MSFT TSLA
Date
2021-09-20 139.419540 137.411942 282.447693 243.389999
2021-09-21 139.897461 137.722473 282.927643 246.460007
2021-09-22 142.257874 138.961197 286.555389 250.646667
2021-09-23 143.213745 139.884888 287.495911 251.213333
2021-09-24 143.301529 140.874466 287.294434 258.130005
<Axes: xlabel='Date'>
Teilweise verlaufen alle 4 Kurse sehr ähnlich, teilweise aber auch individuell. Sinnvoll ist daher der Übergang zu den Renditen und die Analyse derer Abhängigkeiten.
renditen = close_df.pct_change()
print(renditen.head())
renditen.plot(alpha = 0.7)Ticker AAPL GOOGL MSFT TSLA
Date
2021-09-20 NaN NaN NaN NaN
2021-09-21 0.003428 0.002260 0.001699 0.012614
2021-09-22 0.016872 0.008994 0.012822 0.016987
2021-09-23 0.006719 0.006647 0.003282 0.002261
2021-09-24 0.000613 0.007074 -0.000701 0.027533
<Axes: xlabel='Date'>
Während oben bereits der zeitliche Verlauf unterschiedliche Zusammenhänge verdeutlicht, ist die Darstellung in Scatterplots übersichtlicher:
pd.plotting.scatter_matrix(renditen, figsize=(6, 6), diagonal="hist")
plt.show()
sns.pairplot(renditen)
plt.show()
Natürlich können auch nur einzelne Paare beispielsweise mittels der Seaborn Funktionen scatterplot() oder relplot() dargestellt werden. Auf den ersten Blick unterscheiden sich die Funktionen nicht, allerdings liefert die zweite Funktionen flexiblere Anpassungsmöglichkeiten[5].
sns.scatterplot(data = renditen, x='AAPL', y='TSLA')<Axes: xlabel='AAPL', ylabel='TSLA'>
sns.relplot(data = renditen, x='AAPL', y='TSLA', kind = 'scatter')<seaborn.axisgrid.FacetGrid at 0x78f1285f9fa0>
Alle Scatter-Plots zeigen einen mehr oder weniger starken positiven Zusammenhang zwischen den Renditen zweier Aktien. Steigt die Rendite der einen Aktie, dann steigt üblicherweise auch die der anderen Aktie und fällt die eine Rendite, dann auch die andere. Die einfachste statistische Maßzahl zur Erfassung des Zusammenhangs sind die (empirische) Kovarianz und Korrelation[6], die allerdings nur den linearen Zusammenhang erfassen. Die (unverzerrte) empirische Kovarianz zweier Stichproben wird mittels
berechnet. Die Korrelation entsteht durch Normierung und ist einfacher zu interpretieren
Pandas hat die Berechnung der empirischen Kovarianz- und Korrelation bereits implementiert und fasst alle paarweisen Kombinationen in der Kovarianz- bzw. Korrelationsmatrix zusammen. Auf der Diagonalen der Kovarianzmatrix stehen also die Varianzen.
kov_matrix = renditen.cov()
print(kov_matrix)Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.000312 0.000184 0.000166 0.000307
GOOGL 0.000184 0.000411 0.000197 0.000315
MSFT 0.000166 0.000197 0.000316 0.000257
TSLA 0.000307 0.000315 0.000257 0.001423
korr_matrix = renditen.corr()
print(korr_matrix)Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 1.000000 0.514728 0.530035 0.461106
GOOGL 0.514728 1.000000 0.548350 0.412389
MSFT 0.530035 0.548350 1.000000 0.383063
TSLA 0.461106 0.412389 0.383063 1.000000
Zum Abschluss zeichnen wir noch die Regressionsgerade in den Scatterplot ein, um den linearen Zusammenhang zu veranschaulichen. Mit Regressionsmodellen beschäftigen wir und noch ausführlich in Abschnitt Regressionsmodelle
sns.regplot(data=renditen, x="AAPL", y="MSFT", ci = None)<Axes: xlabel='AAPL', ylabel='MSFT'>
👉Der Zusammenhang der täglichen Log-Returns ist völlig analog zu analysieren und sollte zu Übungszwecken selbstständig durchgeführt werden.
Achtung: Vorsicht bei der Skalierung der ‘zeitlinearen’ Log-Returns um von Tages-Returns zu Jahres-Returns überzugehen
Wir haben bei der Analyse der Tages-Returns gesehen, dass die Unterscheidung zwischen Log-Returns (zeitstetige Returns) und Renditen (arithmetische Returns, zweitdiskrete Returns) nur unwesentliche Unterschiede aufzeigen, da für Tages-Kurse beide Return-Begriffe zu verschiedenen, aber sehr ähnlichen Werten führen. Beide Definitionen haben entscheidente Vor- aber auch Nachteile. Die Log-Returns werden aufgrund ihrer kumulierenten Summeneigenschaft sowie der damit engen Verbindung mit der Normalverteilung (zentraler Grenzwertsatz) häufig für zeitstetige Modelle oder Modelle mit Normalverteilungsannahmen verwendet. Insbesondere ist der Übergang von täglichen zu jährlichen Returns im Gegensatz zu den Renditen sehr einfach. Wir werden in Abschnitt Portfolio-Returns noch sehen, dass sich die Portfoliorendite von der Anfangsinvestition zum Zeitpunkt 0 bis nach einfach als gewichtete Summe der Aktien-Renditen von 0 bis berechnen lässt, was für Log-Returns nur näherungsweise gilt. Dennoch haben sich aber wegen der einfachereren Skalierbarkeit auch hier die Log-Returns gegenüber den Renditen durchgesetzt.
Werden allgemein die Aktienkurse zu den Zeitpunkten gemessen, so kann man die annualisierten Log-Returns (siehe Vorlesungsskript Portfoliooptimierung Prof. Pichler) definieren als
Dann muss allerdings auch der Gesamt-Return von nach annualisiert werden
Für äquividistante Tagesdaten wählt man , so dass , für Monatskurse erhält man entsprechend und für Quartalsdaten entsprechend .
trading_days = 252log_returns = np.log(renditen + 1)
mu = log_returns.mean()
mu_tilde = renditen.mean()
geo_mean_renditen = np.exp((np.log(renditen+1)).mean()) - 1
print("mean daily R %s: \n " % mu_tilde)
print("geometric mean daily R %s: \n" % geo_mean_renditen)
print("check: geo mean Rendite = exp(mean daily log)-1 = %s \n" % (np.exp(mu)-1) )
print("Daily log-returns %s: \n" % mu)mean daily R Ticker
AAPL 0.000857
GOOGL 0.000950
MSFT 0.000602
TSLA 0.001030
dtype: float64:
geometric mean daily R Ticker
AAPL 0.000702
GOOGL 0.000745
MSFT 0.000446
TSLA 0.000322
dtype: float64:
check: geo mean Rendite = exp(mean daily log)-1 = Ticker
AAPL 0.000702
GOOGL 0.000745
MSFT 0.000446
TSLA 0.000322
dtype: float64
Daily log-returns Ticker
AAPL 0.000702
GOOGL 0.000745
MSFT 0.000445
TSLA 0.000322
dtype: float64:
#annualization: from daily means to yearly means
mu_year = mu * trading_days
mu_tilde_year = (mu_tilde+1) ** trading_days - 1
mu_tilde_year_approx1 = mu_tilde * trading_days
mu_tilde_year_approx2 = np.exp(mu_year) -1
#mu_tilde_year_approx3 = mu_year
print("mu year (Log-Returns r) %s: \n " % mu_year)
print("mu_tilde year (Renditen R) %s: \n " % mu_tilde_year)
print("Approximation1 : mu_tilde_year = mu_tilde * trading days %s\n " % (mu_tilde_year_approx1))
print("Approximation2: exp(mu_year) -1 %s: \n" % (mu_tilde_year_approx2))
mu year (Log-Returns r) Ticker
AAPL 0.176844
GOOGL 0.187620
MSFT 0.112254
TSLA 0.081032
dtype: float64:
mu_tilde year (Renditen R) Ticker
AAPL 0.241070
GOOGL 0.270190
MSFT 0.163871
TSLA 0.296160
dtype: float64:
Approximation1 : mu_tilde_year = mu_tilde * trading days Ticker
AAPL 0.216067
GOOGL 0.239280
MSFT 0.151797
TSLA 0.259539
dtype: float64
Approximation2: exp(mu_year) -1 Ticker
AAPL 0.193445
GOOGL 0.206375
MSFT 0.118797
TSLA 0.084406
dtype: float64:
from datetime import datetime
print(log_returns.head())
print(log_returns.tail())
annulalized_log_returns = log_returns.copy()
kalendertage = (annulalized_log_returns.index[-1] - annulalized_log_returns.index[0]).days
print("Tage insgesamt: %s, Jahre: %s" % (kalendertage, kalendertage / 365))
#annulalized_log_returns = annulalized_log_returns.reset_index()
for i in range(1,len(log_returns)):
annulalized_log_returns.iloc[i] = annulalized_log_returns.iloc[i]* 365 / (annulalized_log_returns.index[i] - annulalized_log_returns.index[i-1]).days
print(annulalized_log_returns.head() )
print(annulalized_log_returns.tail() )
mu_annulalized_log_returns = annulalized_log_returns.mean()
print(mu_annulalized_log_returns)
Ticker AAPL GOOGL MSFT TSLA
Date
2021-09-20 NaN NaN NaN NaN
2021-09-21 0.003422 0.002257 0.001698 0.012535
2021-09-22 0.016732 0.008954 0.012741 0.016845
2021-09-23 0.006697 0.006625 0.003277 0.002258
2021-09-24 0.000613 0.007049 -0.000701 0.027161
Ticker AAPL GOOGL MSFT TSLA
Date
2026-09-14 0.002435 0.031665 0.019540 -0.017863
2026-09-15 -0.005238 -0.012702 -0.016539 -0.006680
2026-09-16 0.003224 -0.006135 -0.013814 0.004198
2026-09-17 0.013714 0.012924 0.015081 0.022423
2026-09-18 -0.002585 0.006343 -0.008008 -0.005284
Tage insgesamt: 1824, Jahre: 4.997260273972603
Ticker AAPL GOOGL MSFT TSLA
Date
2021-09-20 NaN NaN NaN NaN
2021-09-21 1.249055 0.823918 0.619701 4.575145
2021-09-22 6.107067 3.268261 4.650342 6.148247
2021-09-23 2.444337 2.418168 1.196027 0.824266
2021-09-24 0.223661 2.573005 -0.255882 9.913707
Ticker AAPL GOOGL MSFT TSLA
Date
2026-09-14 0.296234 3.852542 2.377403 -2.173367
2026-09-15 -1.911736 -4.636355 -6.036572 -2.438288
2026-09-16 1.176808 -2.239320 -5.042114 1.532199
2026-09-17 5.005527 4.717240 5.504390 8.184496
2026-09-18 -0.943498 2.315097 -2.922873 -1.928786
Ticker
AAPL 0.273559
GOOGL 0.214014
MSFT 0.164623
TSLA -0.065089
dtype: float64
Sigma_day = log_returns.cov()
Sigma_year = Sigma_day * trading_days
Sigma_tilde_day = renditen.cov()
#Dummy zur simultanen Berechnung von (mu_tilde_i + 1)(mu_tilde_j + 1)
mu_tilde_dummy = np.outer(mu_tilde + 1, mu_tilde + 1)
#print(mu_tilde_dummy)
Sigma_tilde_year = (Sigma_tilde_day + mu_tilde_dummy)**trading_days - mu_tilde_dummy**trading_days
Sigma_tilde_year_approx1 = Sigma_year
Sigma_tilde_year_approx2 = Sigma_tilde_day * trading_days
print("Annualized covarince R (percentege changes)")
print(Sigma_tilde_year)
print("Approx1: Annualized covarince R (percentege changes): Sigma \approx Sigma_tilde")
print(Sigma_tilde_year_approx1)
print("Approx2: Annualized covarince R (percentege changes): yearly cov = daily cov * 252")
print(Sigma_tilde_year_approx2)
print("Annualized covariance r (log retunrs)")
print(Sigma_year)
Annualized covarince R (percentege changes)
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.125856 0.074799 0.061773 0.129271
GOOGL 0.074799 0.175493 0.075289 0.135806
MSFT 0.061773 0.075289 0.112031 0.100651
TSLA 0.129271 0.135806 0.100651 0.722136
Approx1: Annualized covarince R (percentege changes): Sigma pprox Sigma_tilde
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.078235 0.046176 0.041661 0.077034
GOOGL 0.046176 0.103156 0.049664 0.079201
MSFT 0.041661 0.049664 0.078882 0.064420
TSLA 0.077034 0.079201 0.064420 0.356993
Approx2: Annualized covarince R (percentege changes): yearly cov = daily cov * 252
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.078691 0.046446 0.041941 0.077453
GOOGL 0.046446 0.103472 0.049756 0.079431
MSFT 0.041941 0.049756 0.079570 0.064702
TSLA 0.077453 0.079431 0.064702 0.358550
Annualized covariance r (log retunrs)
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.078235 0.046176 0.041661 0.077034
GOOGL 0.046176 0.103156 0.049664 0.079201
MSFT 0.041661 0.049664 0.078882 0.064420
TSLA 0.077034 0.079201 0.064420 0.356993
log_returns_scaled = log_returns * trading_days
print(log_returns_scaled.mean())
print(mu_year)
print(log_returns_scaled.cov())
print(Sigma_year)Ticker
AAPL 0.176844
GOOGL 0.187620
MSFT 0.112254
TSLA 0.081032
dtype: float64
Ticker
AAPL 0.176844
GOOGL 0.187620
MSFT 0.112254
TSLA 0.081032
dtype: float64
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 19.715259 11.636300 10.498492 19.412602
GOOGL 11.636300 25.995245 12.515409 19.958636
MSFT 10.498492 12.515409 19.878285 16.233901
TSLA 19.412602 19.958636 16.233901 89.962287
Ticker AAPL GOOGL MSFT TSLA
Ticker
AAPL 0.078235 0.046176 0.041661 0.077034
GOOGL 0.046176 0.103156 0.049664 0.079201
MSFT 0.041661 0.049664 0.078882 0.064420
TSLA 0.077034 0.079201 0.064420 0.356993
Portfolio-Returns
Aus den obigen 4 Aktien stellen wir jetzt ein Portfolio zusammen und investieren 1000$ zu 10% in 1. Aktie (AAPL), 30% in 2. Aktie (MSFT), 40% in 3. Aktie (GOOGL) und die verbleibenden 20% in 4.Aktie (TSLA) und schichten das Portfolio im Folgenden nicht mehr um. Die Gewichtung ist hier übrigens absolut willkürlich gewählt und kann beliebig geändert werden. Uns interessiert die Wertentwicklung des Portfolios und daher betrachten wir die Portfolio-Returns bzw. Renditen.
Achtung wenn der Vektor mit den Aktientickern wie in diesem Beispiel nicht alphabetisch sortiert ist, kann es beim Zugriff auf die Kurs-Daten der Aktien und Returns Probleme mit der Reihenfolge geben, da die Download-Funktion von yfinance diese automatisch sortiert und somit nicht mehr der ursprünglichen Reihenfolge entspricht. Beim Berechnen der Portfoliowerte und -Returns ist die Reihenfolge allerdings wesentlich. Greift man den DataFrame direkt auf dem Array der Ticker ab, erzwingt man die ursprüngliche Reihenfolge.
#vorgegebene Reihenfolge
print(tickers)
#automatische Sortierung
print(close_df.head())
#urspruengliche Reihenfolge
print(close_df[tickers].head())
calender_days = (close_df.index[-1] - close_df.index[0]).days
trading_days_per_year = 252
trading_days = len(close_df)
print("Kalendertage = %s, Handelstage = %s, Jahre (Handelstage) = %s, Jahre (Kalendertage) =%s"
% (calender_days, trading_days, trading_days / trading_days_per_year, calender_days / 365))
['AAPL', 'MSFT', 'GOOGL', 'TSLA']
Ticker            AAPL       GOOGL        MSFT        TSLA
Date
2021-09-20  139.419540  137.411942  282.447693  243.389999
2021-09-21  139.897461  137.722473  282.927643  246.460007
2021-09-22  142.257874  138.961197  286.555389  250.646667
2021-09-23  143.213745  139.884888  287.495911  251.213333
2021-09-24  143.301529  140.874466  287.294434  258.130005
Ticker AAPL MSFT GOOGL TSLA
Date
2021-09-20 139.419540 282.447693 137.411942 243.389999
2021-09-21 139.897461 282.927643 137.722473 246.460007
2021-09-22 142.257874 286.555389 138.961197 250.646667
2021-09-23 143.213745 287.495911 139.884888 251.213333
2021-09-24 143.301529 287.294434 140.874466 258.130005
Kalendertage = 1824, Handelstage = 1255, Jahre (Handelstage) = 4.98015873015873, Jahre (Kalendertage) =4.997260273972603
Wir nutzen dann später die Tages-Daten zur Schätzung der Kovarianz-Matrix und des Erwartungswertvektors der Returns, die wir zur Berechnung der erwarteten Portfolio-Returns sowie -Varianz benötigen.
Wird in das Portfolio aus jeweils Stocks zum Preis zusammengesetzt (), gilt für den jeweiligen Portfolioanteil der -ten Aktie
mit , wobei den investierte Gesamtbetrag beschreibt. Letztere Gleichung gilt für die Vektoren der Anzahl gekaufter Aktien und den Vektor der Startkurse zur Investitionszeit in .
print(tickers)

weights = np.array([0.1, 0.3, 0.4, 0.2])
print("Summe der Portfoliogewichte = %f" % weights.sum())

#erzwingen urspruengliche Reihenfolge der Aktien im tickers vektor
portfolio = close_df[tickers].copy()
print(portfolio.head())

#vgl. sortiert
print(close_df.head())

#type pandas dataframe
print("Type: %s" % type(portfolio))

startkapital = 1000
S0 = portfolio.iloc[0] #1. Zeile entspricht Startwerten
stueckzahl = weights / S0 *  startkapital
kaufpreis = sum(S0*stueckzahl)

print("kaufen in t=0 Stückzahl %s \n\n zum Preis %s \n\n für insgesamt  %.1f Dollar" % (stueckzahl, S0, kaufpreis) )

#alternative Berechnung als Skalarprodukt:
S0.dot(stueckzahl)
['AAPL', 'MSFT', 'GOOGL', 'TSLA']
Summe der Portfoliogewichte = 1.000000
Ticker            AAPL        MSFT       GOOGL        TSLA
Date
2021-09-20  139.419540  282.447693  137.411942  243.389999
2021-09-21  139.897461  282.927643  137.722473  246.460007
2021-09-22  142.257874  286.555389  138.961197  250.646667
2021-09-23  143.213745  287.495911  139.884888  251.213333
2021-09-24  143.301529  287.294434  140.874466  258.130005
Ticker            AAPL       GOOGL        MSFT        TSLA
Date
2021-09-20  139.419540  137.411942  282.447693  243.389999
2021-09-21  139.897461  137.722473  282.927643  246.460007
2021-09-22  142.257874  138.961197  286.555389  250.646667
2021-09-23  143.213745  139.884888  287.495911  251.213333
2021-09-24  143.301529  140.874466  287.294434  258.130005
Type: <class 'pandas.DataFrame'>
kaufen in t=0 Stückzahl Ticker
AAPL     0.717260
MSFT     1.062144
GOOGL    2.910955
TSLA     0.821726
Name: 2021-09-20 00:00:00, dtype: float64

 zum Preis Ticker
AAPL     139.419540
MSFT     282.447693
GOOGL    137.411942
TSLA     243.389999
Name: 2021-09-20 00:00:00, dtype: float64

 für insgesamt  1000.0 Dollar
np.float64(1000.0)Damit können wir jetzt natürlich auch den Wert des Portfolios zu jedem späteren Zeitpunkt berechnen. Wird das Portfolio bis zum Zeitpunkt nicht umgeschichtet, haben die Aktienkurse den Wert und somit das Portfolio den Wert
Es bietet sich hierfür an die von Pandas bereitgestellten Matrix-Vektor-Operationen zu verwenden, denn die letzte Summe entspricht einfach dem Skalarprodukt zweier Vektoren[7] und die Berechnung der Spalte aller Portfoliowerte über die Zeit entspricht entsprechend einer Matrix-Vektor-Multiplikation, die in Pandas mittels der dot() Funktion bereitgestellt wird (Doku Pandas). Wichtig ist allerdings, dass im DataFrame die Spalten in der gleichen Reihenfolge stehen, wie in den Vektoren - wir haben den DataFrame portfolio extra auf die Ticker-Reihenfolge angepasst, alternativ kann auch immer automatsichen mittels portfolio[tickers] explizit auf die Spalten der Aktien in der enstprechenden Reihenfolge zugegriffen werden.
#Umwandeln in Numpy-Array, um einfacher zu rechnen
print(stueckzahl)
stueckzahl_np = stueckzahl.to_numpy()
print(stueckzahl_np)

portfolio['Portfolio'] = portfolio.dot(stueckzahl_np)
#portfolio['Portfolio'] = portfolio[tickers].dot(stueckzahl_np)

print(portfolio.head())
Ticker
AAPL 0.717260
MSFT 1.062144
GOOGL 2.910955
TSLA 0.821726
Name: 2021-09-20 00:00:00, dtype: float64
[0.71725957 1.06214357 2.91095516 0.82172645]
Ticker AAPL MSFT GOOGL TSLA Portfolio
Date
2021-09-20 139.419540 282.447693 137.411942 243.389999 1000.000000
2021-09-21 139.897461 282.927643 137.722473 246.460007 1004.279219
2021-09-22 142.257874 286.555389 138.961197 250.646667 1016.871594
2021-09-23 143.213745 287.495911 139.884888 251.213333 1021.710637
2021-09-24 143.301529 287.294434 140.874466 258.130005 1030.123834
portfolio.plot()<Axes: xlabel='Date'>
Berechnung der Portfolio-Rendite
Für die Portfolio-Rendite, also den prozentualen Zuwachs bis zum Zeitpunkt des Portfolios gilt wegen
d. h. die Portfolio-Rendite ergibt sich als die gewichtete Summe der Aktien-Renditen und kann bequem mittels Vektoren und Gewichtsvektor auch wieder als Matrix-Vektor Produkt geschrieben werden. Für die Log-Returns gilt diese Beziehung zumindest näherungsweise, wie wir hier für unser Beispiel-Portfolio illustrieren.
#daily returns / taegliche Renditen von t-1, t
print(portfolio.head())

tickers1 = tickers.copy()
tickers1.append("Portfolio")

renditen = portfolio.pct_change()
renditen["Days_Diff"] = renditen.index.to_series().diff().dt.days
renditen[tickers1].plot()
print(renditen.head())
Ticker AAPL MSFT GOOGL TSLA Portfolio
Date
2021-09-20 139.419540 282.447693 137.411942 243.389999 1000.000000
2021-09-21 139.897461 282.927643 137.722473 246.460007 1004.279219
2021-09-22 142.257874 286.555389 138.961197 250.646667 1016.871594
2021-09-23 143.213745 287.495911 139.884888 251.213333 1021.710637
2021-09-24 143.301529 287.294434 140.874466 258.130005 1030.123834
Ticker AAPL MSFT GOOGL TSLA Portfolio Days_Diff
Date
2021-09-20 NaN NaN NaN NaN NaN NaN
2021-09-21 0.003428 0.001699 0.002260 0.012614 0.004279 1.0
2021-09-22 0.016872 0.012822 0.008994 0.016987 0.012539 1.0
2021-09-23 0.006719 0.003282 0.006647 0.002261 0.004759 1.0
2021-09-24 0.000613 -0.000701 0.007074 0.027533 0.008234 1.0

Die Eigenschaft gilt allerdings nur für die Renditen von 0 bis t und nicht für die täglichen, wie die folgende Rechnung zeigt:
#Greifen explitzit nur die Spalten der Aktien-Ticker ab:
renditen["dot_version"] = renditen[tickers].dot(weights)
print(renditen.head())

#loeschen Spalte wieder (da falsch!)
renditen = renditen.drop(columns = ["dot_version"])
Ticker          AAPL      MSFT     GOOGL      TSLA  Portfolio  Days_Diff  \
Date
2021-09-20       NaN       NaN       NaN       NaN        NaN        NaN
2021-09-21  0.003428  0.001699  0.002260  0.012614   0.004279        1.0
2021-09-22  0.016872  0.012822  0.008994  0.016987   0.012539        1.0
2021-09-23  0.006719  0.003282  0.006647  0.002261   0.004759        1.0
2021-09-24  0.000613 -0.000701  0.007074  0.027533   0.008234        1.0

Ticker      dot_version
Date
2021-09-20          NaN
2021-09-21     0.004279
2021-09-22     0.012529
2021-09-23     0.004768
2021-09-24     0.008187
#kumulierte Renditen von 0..t
renditen_kum = renditen.copy()

renditen_kum[tickers1]=(1+renditen_kum[tickers1]).cumprod()-1
renditen_kum["Days"] = renditen_kum["Days_Diff"].cumsum()

renditen_kum["dot_version"] = renditen_kum[tickers].dot(weights)
renditen_kum["check"] = renditen_kum["Portfolio"] - renditen_kum["dot_version"]
renditen_kum["Portfolio-Log-Return"] = np.log(renditen_kum.Portfolio+1)

#print(renditen_kum.tail())

print(renditen_kum[["Portfolio","dot_version","check"]].head())

norm_check_renditen = np.linalg.norm(renditen_kum["check"].dropna(), ord=2)  #euklid
##2-norm vs inf-norm
np.linalg.norm(renditen_kum["check"].dropna(), ord=2)
np.linalg.norm(renditen_kum["check"].dropna(), ord=np.inf)

ax = renditen_kum.plot(y=["Portfolio","dot_version","check","Portfolio-Log-Return"])
ax.lines[0].set_linestyle("--")
ax.lines[1].set_linestyle(":")
ax.lines[2].set_linestyle("-.")
ax.lines[3].set_linestyle("solid")
plt.show()
print("kumulierte Renditen: 2-Norm Fehler = %s (gerundet: %10f)" % (norm_check_renditen,np.round(norm_check_renditen, 10)))
Ticker Portfolio dot_version check
Date
2021-09-20 NaN NaN NaN
2021-09-21 0.004279 0.004279 0.000000e+00
2021-09-22 0.016872 0.016872 4.510281e-17
2021-09-23 0.021711 0.021711 1.769418e-16
2021-09-24 0.030124 0.030124 2.636780e-16

kumulierte Renditen: 2-Norm Fehler = 1.122967449452428e-13 (gerundet: 0.000000)
Wir sehen dass die beiden Spalten ‘Portfolio’, bei dem die Zuwachsraten von 0 bis t direkt aus den Portfoliowerten, und die Spalte ‘dot_version’, bei dem die kumulierten Portfolio-Renditen als gewichtete Summe wie in Formel eq-weigthed-ret berechnet wurden bis auf minimale numerische Fehler (Spalte ‘check’ mit Norm nahe Null) tatsächlich übereinstimmen.
renditen_kum.plot(y=["check"])<Axes: xlabel='Date'>
Ein Plot der kumulierten Returns aller einzelnen Aktien sowie des Portfolios zeigt die Diversifikationseffekte recht deutlich, denn die Volatilität der Tesla-Aktie, in die 20% investiert wurde, wird deutlich ausgeglättet, obwohl alle Renditen einen positiven Zusammenhang aufweisen.
renditen_kum[tickers1].plot()<Axes: xlabel='Date'>
Die Berechnung der Log-Returns des Portfolios läuft analog (aus Bequemlichkeit rechnen wir hier einfach die Renditen in Log-Returns nach Formel Rendite vs. Log-Returns um, allerdings kann man wie oben gezeigt auch direkt die Log-Returns mittels diff() Operator ausrechnen
log_returns = renditen.copy()
log_returns[tickers1] = np.log(renditen[tickers1] + 1)
log_returns[tickers1].plot()
plt.show()


print(log_returns.head())

Ticker          AAPL      MSFT     GOOGL      TSLA  Portfolio  Days_Diff
Date
2021-09-20       NaN       NaN       NaN       NaN        NaN        NaN
2021-09-21  0.003422  0.001698  0.002257  0.012535   0.004270        1.0
2021-09-22  0.016732  0.012741  0.008954  0.016845   0.012461        1.0
2021-09-23  0.006697  0.003277  0.006625  0.002258   0.004747        1.0
2021-09-24  0.000613 -0.000701  0.007049  0.027161   0.008201        1.0
log_returns2 = portfolio.copy()
log_returns2[tickers1] = np.log(log_returns2[tickers1]).diff()
print(log_returns2.head())
Ticker          AAPL      MSFT     GOOGL      TSLA  Portfolio
Date
2021-09-20       NaN       NaN       NaN       NaN        NaN
2021-09-21  0.003422  0.001698  0.002257  0.012535   0.004270
2021-09-22  0.016732  0.012741  0.008954  0.016845   0.012461
2021-09-23  0.006697  0.003277  0.006625  0.002258   0.004747
2021-09-24  0.000613 -0.000701  0.007049  0.027161   0.008201
Übergang von täglichen Returns zu kumulierten Returns:
log_returns_kum = log_returns.copy()
log_returns_kum["Days"] = log_returns_kum["Days_Diff"].cumsum()
log_returns_kum[tickers1] = log_returns_kum[tickers1].cumsum()

log_returns_kum["dot_version"] = log_returns_kum[tickers].dot(weights)
log_returns_kum["check"] = log_returns_kum["Portfolio"] - log_returns_kum["dot_version"]
log_returns_kum["Portfolio-Rendite"] = np.exp(log_returns_kum.Portfolio) - 1


print(log_returns_kum[["Portfolio","dot_version","check"]].head())

norm_check_log_returns = np.linalg.norm(log_returns_kum["check"].dropna(), ord=2)  #euklid
##2-norm vs inf-norm
np.linalg.norm(log_returns_kum["check"].dropna(), ord=2)
np.linalg.norm(log_returns_kum["check"].dropna(), ord=np.inf)

ax = log_returns_kum.plot(y=["Portfolio","dot_version","check","Portfolio-Rendite"])
ax.lines[0].set_linestyle("--")
ax.lines[1].set_linestyle(":")
ax.lines[2].set_linestyle("-.")
ax.lines[3].set_linestyle("solid")
plt.show()
print("kumulierte Log-Returns: 2-Norm Fehler = %s (gerundet: %10f)" % (norm_check_log_returns,np.round(norm_check_log_returns, 10)))

#log_returns_kum.head()
Ticker Portfolio dot_version check
Date
2021-09-20 NaN NaN NaN
2021-09-21 0.004270 0.004261 0.000009
2021-09-22 0.016731 0.016707 0.000024
2021-09-23 0.021478 0.021462 0.000017
2021-09-24 0.029679 0.029565 0.000114

kumulierte Log-Returns: 2-Norm Fehler = 0.5862925343859002 (gerundet: 0.586293)
log_returns_kum.plot(y=["check"])<Axes: xlabel='Date'>
Wir sehen also, dass für die kumulierten Log-Returns des Portfolios zumindest näherungsweise gilt. Die Graphiken zeigen, dass der Fehler überschaubar ist.
Zufalls-Modell
Wir haben im vorherigen Abschnitt gesehen, dass für die Portfolio-Rendite gilt und für die Log-Returns diese Beziehung in sehr guter Näherung gilt. Aus diesem Grund wird der zufällige Portfolio-Return häufig mittels
unabhängig von der tatsächlich verwendeten Return-Definition angesetzt, wobei der Vektor der Aktien-Returns bis zum Zeitpunkt t als Zufallsvariable modelliert wird. Die Porfolio-Theorie beschäftigt sich mit einer geeigneten Wahl des Gewichtsvektors unter verschiedenen Risiko-Kriterien. Im klassichen Markowitz Modell geht man davon aus, dass die zufällige Rendite aller Aktien einer multivariaten Normalverteilung genügt und daher durch die ersten beiden Momente und vollständig das Zufallsverhalten charakterisieren. Für beliebig verteilte Zufallsvektoren reichen die ersten beiden Momente der Verteilung nicht. Wir haben oben gesehen, dass Log-Returns (zeitstetige Modelle) und die prozentualen Renditen (zeitdiskrete Modelle, arithmetische Returns) sich zwar leicht unterscheiden und aus mathematischer Sicht jeweils Vor- und Nachteile mitbringen. Während die Log-Returns aufgrund ihrer Additivität eher mit der Normalverteilungsannahme[8] einhergehen, folgen die Renditen dann wegen Formel Rendite vs. Log-Returns einer Log-Normalverteilung.
Ein weiterer Vorteil der Log-Returns gegenüber den Renditen ist die einfachere Skalierbarkeit der ersten beiden Momente und , so dass diese aus den vorhandenen Tages-Returns geschätzt werden können und dann wie in Abschnitt Annualisierte Returns beschrieben, einfach auf den Anlagezeitraum von 0 bis t skaliert werden können. Daher werden häufig die Log-Returns in der Finanzmathematik und insbesondere in der Portfolio-Theorie verwendet. Häufig unterstellt man für effiziente Finanzmärkte die Unkorreliertheit der Tages-Returns zwischen verschiedenen Handelstagen, wie wir das auch für die Skalierung der annualizierten Momente ausgenutzt haben, so dass alle relevanten und verfügbaren Informationen über die Aktiengesellschaften tatsächlich schon in den aktuellen Kursen eingepreist sind.
Portfolioanalyse: erwarteter Portfolio-Return und Portfolio-Varianz
Wegen Formel (46) können wir die erwartete Rendite sowie die Portfolio-Varianz einfach mittels der ersten beiden Momente des Zufalls-Vektors der Aktien-Returns sowie ableiten
Üblicherweise werden, wie in Annualisierte Returns beschrieben, aus den Tages-Log-Returns mit Hilfe des arithmetsichen Mittels die erwarteten Tages-Returns bzw. Renditen geschätzt sowie deren Kovarianzmatrix berechnet und anschließend durch Skalierung annualisiert und verwendet den Zusammenhang zwischen arithmetischen und geometrischen Mittel zur Annualisierung der Renditen. Da wir streng genommen diese Annualisierung nur für die Log-Returns einfach berechnen können, kann man aber danach wieder zu den Renditen mittels Formel Rendite vs. Log-Returns übergehen. In der Praxis wird das nicht immer so konsequent unterschieden, aber wir haben ja gesehen, dass die Unterschiede zwischen Log-Returns und Renditen für kleinere Zeiträume nicht so deutlich sind, die folgenden Rechnungen zeigen dennoch die Probleme bei der Approximation auf. Aus diesem Grund wird tatsächlich bevorzugt mit den Log-Returns in der Portfolio-Theorie gearbeitet.
mu_day = log_returns[tickers].mean()
mu_year = mu_day * trading_days_per_year

print(mu_year)
Ticker
AAPL 0.176844
MSFT 0.112254
GOOGL 0.187620
TSLA 0.081032
dtype: float64
mu_tilde_day = renditen[tickers].mean()
geo_mean_renditen = np.exp((np.log(renditen[tickers]+1)).mean()) - 1

print("mean daily R %s: \n " % mu_tilde_day)
print("geometric mean daily R %s: \n" % geo_mean_renditen)
mean daily R Ticker
AAPL     0.000857
MSFT     0.000602
GOOGL    0.000950
TSLA     0.001030
dtype: float64:

geometric mean daily R Ticker
AAPL     0.000702
MSFT     0.000446
GOOGL    0.000745
TSLA     0.000322
dtype: float64:
print("check: geo mean Rendite = exp(mean daily log)-1 = %s \n" % (np.exp(mu_day)-1) )
print("Daily log-returns %s: \n" % mu_day)
check: geo mean Rendite = exp(mean daily log)-1 = Ticker
AAPL 0.000702
MSFT 0.000446
GOOGL 0.000745
TSLA 0.000322
dtype: float64
Daily log-returns Ticker
AAPL 0.000702
MSFT 0.000445
GOOGL 0.000745
TSLA 0.000322
dtype: float64:
Wir sehen Abweichungen zwischen den geometrischen und arithmetischen Mittelwerten der täglichen Renditen bzw. Log-Returns. Außerdem sehen wir den den nichtlineare Zusammenhang zwischen mittleren Log-Returns und geometrischen Mittel der Renditen. Nun werden diese Mittel annualisiert.
mu_tilde_year  = (mu_tilde_day[tickers]+1) ** trading_days_per_year - 1

mu_tilde_year_approx1 = mu_tilde_day * trading_days_per_year
mu_tilde_year_approx2 = np.exp(mu_year) -1

print("mu year (Log-Returns r) %s: \n " % mu_year)
print("mu_tilde year (Renditen R) %s: \n " % mu_tilde_year)
print("Approximation1 für Renditen: mu_tilde_year = mu_tilde * trading days_per_year %s\n " % (mu_tilde_year_approx1))
print("Approximation2 für Renditen: exp(mu_year) -1  %s: \n" % (mu_tilde_year_approx2))
mu year (Log-Returns r) Ticker
AAPL     0.176844
MSFT     0.112254
GOOGL    0.187620
TSLA     0.081032
dtype: float64:

mu_tilde year (Renditen R) Ticker
AAPL     0.241070
MSFT     0.163871
GOOGL    0.270190
TSLA     0.296160
dtype: float64:

Approximation1 für Renditen: mu_tilde_year = mu_tilde * trading days_per_year Ticker
AAPL     0.216067
MSFT     0.151797
GOOGL    0.239280
TSLA     0.259539
dtype: float64

Approximation2 für Renditen: exp(mu_year) -1  Ticker
AAPL     0.193445
MSFT     0.118797
GOOGL    0.206375
TSLA     0.084406
dtype: float64:
Die Auswirkungen auf die erwartete jährliche Portfoliorendite je nach Berechnungsart:
print("erwartete annualisierte Portfoliorendite: \n"
"  %f (mu_tilde_year -- Rendite correct) \n"
"  %f (mu_year -- Log-Returns) \n"
"  %f (Approx1 Rendite) \n"
"  %f (Approx2 Rendite) \n" %
      (mu_tilde_year.dot(weights),mu_year.dot(weights), mu_tilde_year_approx1.dot(weights), mu_tilde_year_approx2.dot(weights)))
erwartete annualisierte Portfoliorendite:
0.240576 (mu_tilde_year -- Rendite correct)
0.142615 (mu_year -- Log-Returns)
0.214766 (Approx1 Rendite)
0.154415 (Approx2 Rendite)
Die 1. Approximation liefert bessere Ergebnisse für die Renditen, allerdings ist dieser Ansatz bei der Approximation der Kovarianz zu grob.
Kovarianz- und Korrelationsmatzrix für Log-Returns
Sigma_day = log_returns[tickers].cov()
Sigma_year = Sigma_day * trading_days_per_year

print("Tages vs. Jahres-Kovarianz für Log-Returns")
print(Sigma_day)
print(Sigma_year)
Tages vs. Jahres-Kovarianz für Log-Returns
Ticker      AAPL      MSFT     GOOGL      TSLA
Ticker
AAPL    0.000310  0.000165  0.000183  0.000306
MSFT    0.000165  0.000313  0.000197  0.000256
GOOGL   0.000183  0.000197  0.000409  0.000314
TSLA    0.000306  0.000256  0.000314  0.001417
Ticker      AAPL      MSFT     GOOGL      TSLA
Ticker
AAPL    0.078235  0.041661  0.046176  0.077034
MSFT    0.041661  0.078882  0.049664  0.064420
GOOGL   0.046176  0.049664  0.103156  0.079201
TSLA    0.077034  0.064420  0.079201  0.356993
Kovarianz- und Korrelationsmatzrix für Renditen
Sigma_tilde_day = renditen[tickers].cov()

#Dummy zur simultanen Berechnung von (mu_tilde_i + 1)(mu_tilde_j + 1)
mu_tilde_dummy = np.outer(mu_tilde + 1, mu_tilde + 1)
#print(mu_tilde_dummy)

Sigma_tilde_year = (Sigma_tilde_day + mu_tilde_dummy)**trading_days_per_year - mu_tilde_dummy**trading_days_per_year

Sigma_tilde_year_approx1 = Sigma_tilde_day * trading_days_per_year

#Delta Method:
exp_mu_year = np.exp(mu_year)
Sigma_tilde_year_approx2 =  (Sigma_year.dot(np.diag(exp_mu_year))).dot(np.diag(exp_mu_year))


#(Sigma_year.dot(weights)).dot(weights)

print("Tages vs. Jahres-Kovarianz für R")
print(Sigma_tilde_day)
print(Sigma_tilde_year)

print("Approx1 für R: Sigma \approx Sigma_tilde")
print(Sigma_tilde_year_approx1)

print("Approx2 für R: cov(R) = cov(e^r - 1) = cov(e^r) approx e^r cov(r) (e^r)^T (Delta-Methode für R_t = exp(r_t) - 1)")
print(Sigma_tilde_year_approx2)
Tages vs. Jahres-Kovarianz für R
Ticker AAPL MSFT GOOGL TSLA
Ticker
AAPL 0.000312 0.000166 0.000184 0.000307
MSFT 0.000166 0.000316 0.000197 0.000257
GOOGL 0.000184 0.000197 0.000411 0.000315
TSLA 0.000307 0.000257 0.000315 0.001423
Ticker AAPL MSFT GOOGL TSLA
Ticker
AAPL 0.125856 0.067392 0.068563 0.129271
MSFT 0.067392 0.133337 0.075289 0.109807
GOOGL 0.068563 0.075289 0.147451 0.124483
TSLA 0.129271 0.109807 0.124483 0.722136
Approx1 für R: Sigma pprox Sigma_tilde
Ticker AAPL MSFT GOOGL TSLA
Ticker
AAPL 0.078691 0.041941 0.046446 0.077453
MSFT 0.041941 0.079570 0.049756 0.064702
GOOGL 0.046446 0.049756 0.103472 0.079431
TSLA 0.077453 0.064702 0.079431 0.358550
Approx2 für R: cov(R) = cov(e^r - 1) = cov(e^r) approx e^r cov(r) (e^r)^T (Delta-Methode für R_t = exp(r_t) - 1)
0 1 2 3
Ticker
AAPL 0.111431 0.052147 0.067202 0.090587
MSFT 0.059338 0.098737 0.072279 0.075754
GOOGL 0.065769 0.062165 0.150127 0.093135
TSLA 0.109721 0.080635 0.115264 0.419801
Die deutlich bessere 2. Approximation basiert auf der Delta-Methode.
Portvoliovarianz berechnet:
Für die Log-Returns
P_log_var_year = (Sigma_year.dot(weights)).dot(weights)
print(P_log_var_year)

#alternative Berechnung mittels matmult
print(np.matmul(weights.transpose(), np.matmul(Sigma_year, weights)))
0.08026347097026416
0.08026347097026416
Für die Renditen
P_var_year = (Sigma_tilde_year.dot(weights)).dot(weights)
print(P_var_year)
0.13159936958557508
P_var_year_approx1 = (Sigma_tilde_year_approx1.dot(weights)).dot(weights)
P_var_year_approx2 = (Sigma_tilde_year_approx2.dot(weights)).dot(weights)
print(P_var_year_approx1)
print(P_var_year_approx2)
0.08059070495032523
0.10567107051384317
print("annualisierte Varianz der Portfolio-Rendite: \n"
"  %f (korrekt) \n"
"  %f (Approx1) \n"
"  %f (Approx2) \n" %
      (P_var_year, P_var_year_approx1, P_var_year_approx2))
annualisierte Varianz der Portfolio-Rendite:
0.131599 (korrekt)
0.080591 (Approx1)
0.105671 (Approx2)
Die Indexierung des Datums kann einfach mittels Aufruf der Funktion
dataframe.set_index('Date')gesetzt werden.Standardmäßig basiert der Kerndichteschätzer auf glockenförmig überlagerten Gaussfunktionen, es können allerdings auch andere Kernels zur Schätzung verwendet werden, hier soll darauf allerdings nicht weiter eingegangen werden. Beispielsweise liefert das Statsmodels-Package verschiedene andere Kernels.
Die Parameter der Normalverteilung werden mittels der Funktion
fit()vpm Normalverteilungs-Sub -Package geschätzt, können aber natürlich auch einfach mittels aritmetischen Mittel und empirischer Standardabweichung aus dem Numpy-Package geschätzt werden. Die Funktion
relplot()erzeugt sogenannte ‘relational plots’ und kann neben Scatter-Plots auch Line-Plots erzeugen und kann im Gegensatz zuscatterplot()mehrere Sub-Plots in einer Graphik darstellen. Für Details und Beispiele verweisen wir hier auf die Seaborn-Doku.Die Kovarianz zweier Zufallsvariablen und ist definiert als und die Korrelation nach Pearson skaliert die Werte für eine bessere Interpretierbarkeit. Aus Unabhängigkeit folgt wegen gerade und somit Unkorreliertheit, die Rückrichtung gilt allerdings im Allgemeinen nicht, beispielsweise sind und offensichtlich abhängig (quadratischer Zusammenhang), aber unkorrelierte Zufallsvariablen da gilt.
Für die Log-Returns von 0 bis zum Zeitpunkt t gilt , d. h. wenn wir die täglichen Log-Returns als iid (identisch und unabhängig verteilt) annehmen, so folgt aus dem zentralen Grenzwertsatz automatisch die Normalverteilung der Summe . Obige Auswertung hat gezeigt, dass die täglichen Returns zwar von einer Normalverteilung abweichen, aber dennoch einen glockenförmige Verteilung besitzen.