Regressionsmodelle
In diesem Kapitel werden wir uns ausführlich mit Regressionsmodellen als grundlegendes Werkzeuge der quantitativen Analyse beschäftigen. Ziel ist es, sowohl das theoretische Verständnis linearer Modelle zu vermitteln als auch deren praktische Umsetzung in Python zu beherrschen. Dazu erarbeiten wir zunächst die statistischen Grundlagen und implementieren einfache und multiple lineare Regressionen Schritt für Schritt mit NumPy, bevor wir anschließend die Ansätze etablierter Statistik-Bibliotheken wie statsmodels oder scikit-learn kennenlernen.
Für den Einstieg betrachten wir die Konstruktion einer einfachen Regressionsgeraden, um das Prinzip der Parameterschätzung und der Fehlerquadratsumme anschaulich zu verstehen, und verallgemeinern diese Überlegungen dann auf höherdimensionale Modelle. Aufbauend darauf beschäftigen wir uns mit statistischen Tests auf Regressionskoeffizienten, Konfidenzintervallen und Modellgüte sowie mit ANOVA-Konzepten, die helfen, Modelle systematisch zu bewerten.
Literatur: beispielsweise Bortz & Schuster (2011), Pruscha (2000) oder Stock & Watson (2020)
Abschließend widmen wir uns Anwendungen im Bereich der Finanzzeitreihen. Dabei stehen insbesondere die Voraussetzungen klassischer Regressionsmodelle im Vordergrund – vor allem die Annahme unabhängiger Beobachtungen – und welche Besonderheiten bei abhängigen Daten wie Rendite-Reihen beachtet werden müssen.
Motivation: Bestimmung der Regressionsgeraden
Scatterplots, wie im folgenden Beispiel, stellen den Zusammenhang zwischen zwei metrischen Merkmalen und dar. Mit Hilfe von Regressionsmodellen, versucht man die Werte von mit Hilfe von Beobachtungen durch Analyse der Stichprobenpaare vorherzusagen. Das einfachste Modell
unterstellt einen linearen Zusammenhang zwischen und , wobei ein zufälliges Rauschen ohne Tendenz () diesen streng funktionellen Zusammenhang etwas aufweicht. Den Fehlerterm bzw. Rauschterm bezeichnet man daher auch als Residuen. Ein allgemeines Modell unterstellt einen funktionalen Zusammenhang zwischen und , der mit Hilfe der Funktion beschrieben wird. In obigen Modell ist die Funktion einfach linear mit , wir können allerdings auch eine quadratische Funktion anpassen. Allgemein bezeichnet
Regressand / abhängige bzw. zu erklärende Variable, d.h. wird mittels erklärt
Regressor / unabhängie bzw. erklärende Variable (häufig deterministisch modelliert)
wobei durchaus auch mehrdimensional sein darf. Das folgende Beispiel stellt den Zusammenhang zwischen Rechnung und Trinkgeldern dar. Der Scatterplot zeigt einen positiven Zusammenhang, je höher die Gesamtrechnung, desto höher auch die gezahlten Trinkgelder.
import seaborn as sns
import matplotlib.pyplot as plt

# tips-Datensatz (Restaurant-Trinkgelder) aus seaborn package
tips = sns.load_dataset("tips")
print(tips.head())

#univariate statistische Kennzahlen
print(tips.describe())

# einfache lineare Regression: Trinkgeld ~ Gesamtrechnung
sns.lmplot(data=tips, x="total_bill", y="tip", ci=None)
plt.title("Lineare Regression: Tip ~ Total Bill")
plt.show()
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4
       total_bill         tip        size
count  244.000000  244.000000  244.000000
mean    19.785943    2.998279    2.569672
std      8.902412    1.383638    0.951100
min      3.070000    1.000000    1.000000
25%     13.347500    2.000000    2.000000
50%     17.795000    2.900000    2.000000
75%     24.127500    3.562500    3.000000
max     50.810000   10.000000    6.000000
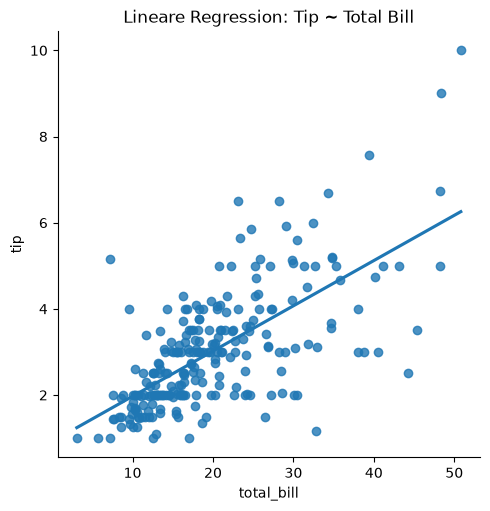
Das Einzeichnen der Regressionsgeraden in solch einen Scatterplot ist denkbar einfach, wir wollen uns aber jetzt näher mit der Bestimmung dieser Geraden beschäftigen.
Das Ziel der Regressionsanalyse ist es die Funktion bzw. deren beschreibenden Parameter zu schätzen durch . Für die einfache lineare Regression müssen daher nur noch die unbekannten Koeffizienten und der Gerade aus den Beobachtungen geschätzt werden. Diese Schätzwerte bezeichnen wir mit und und werden mittels der Methode der kleinsten Quadrate bestimmt, d.h. unter allen Werten und wählen wir diejenigen Werte und , für die die quadrierten Fehler zwischen Beobachtungen und Modellvorhersagen insgesamt am kleinsten sind, d.h. es wird das Minimierungsproblem
gelöst. Das folgende Beispiel illustriert die Methode der kleinsten Quadrate für einen kleinen Datensatz, indem die optimal ermittelte Gerade gegen eine beliebige andere Gerade für einen kleinen Datensatz betrachtet werden.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Datensatz zur Illustration
dataset = pd.DataFrame({
    "x": [1, 2, 3, 4, 5],
    "y": [17, 7, 11, 2, 3]
})

# Designmatrix X mit Intercept
X = np.column_stack([
    np.ones(len(dataset)),
    dataset["x"].to_numpy()
])
y = dataset["y"].to_numpy()

# Kleinste-Quadrate-Schätzer
beta, residuals, rank, s = np.linalg.lstsq(X, y, rcond=None)
beta0, beta1 = beta

# Vorhersagegitter
x_grid = np.linspace(dataset["x"].min(), dataset["x"].max(), 100)
X_grid = np.column_stack([np.ones(len(x_grid)), x_grid])
y_hat = X_grid @ beta

# Vergleichsgerade
def linear(x, a, b):
    return a + b * x

y2_grid = linear(x_grid, a=4, b=1)

# Regressionswerte (für Residuenlinien)
dataset["fit"] = X @ beta
dataset["fit2"] = linear(dataset["x"], a=4, b=1)

dataset["residuals"] = dataset["y"] - dataset["fit"]
dataset["res2"] = dataset["y"] - dataset["fit2"]

# ==========
#   PLOTS
# ==========
fig, axes = plt.subplots(1, 2, figsize=(13, 5))

# (1) Daten, Regressionsgeraden & Residuen
ax = axes[0]
ax.scatter(dataset["x"], dataset["y"], label="Datenpunkte", color="black", zorder=4)

# OLS-Gerade
ax.plot(x_grid, y_hat, label="KQ-Regressionsgerade", color="blue")

# Vergleichsgerade
ax.plot(x_grid, y2_grid, label="Vergleichsgerade: y = 4 + x", linestyle="--", color="orange")

# Residuenlinien für OLS-Geraden (blau)
for xi, yi, fi in zip(dataset["x"], dataset["y"], dataset["fit"]):
    ax.plot([xi, xi], [yi, fi], color="blue", linewidth=1)

# Residuenlinien für Vergleichsgerade (orange)
for xi, yi, fi2 in zip(dataset["x"], dataset["y"], dataset["fit2"]):
    ax.plot([xi, xi], [yi, fi2], color="orange", linewidth=1)

ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_title("Regression, Vergleichsgerade und Residuen")
ax.legend()

# (2) Residuenplot
ax2 = axes[1]
ax2.axhline(0, color="black", linewidth=1)

ax2.scatter(dataset["x"], dataset["residuals"], label="Residuen Regressions-Modell", color="blue")
ax2.scatter(dataset["x"], dataset["res2"], label="Residuen y=4+x", color="orange", marker="x")

ax2.set_xlabel("x")
ax2.set_ylabel("Residuen")
ax2.set_title("Residuenvergleich")
ax2.legend()

plt.tight_layout()
plt.show()
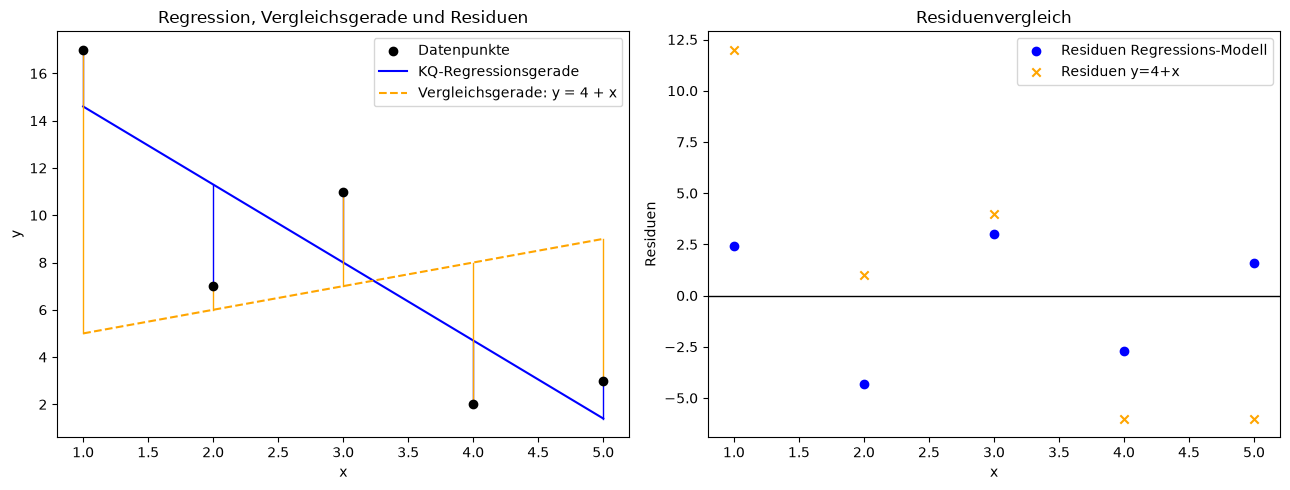
Die Berechnung der Schätzer und diskutieren wir gleich im Detail, aber ein Vergleich der Residuen sowie daraus resultierend der quadrierten Residuensummen zeigt deutlich, dass die blaue Regressionsgerade deutlich besser die Daten vorhersagt als die willkürlich gewählte orange Referenzgerade. Die folgenden Tabellen vergleichen die Residuen beider Modelle
| x | y | ŷ=17.9−3.3x | Ê=y-ŷ | Ê^2 |
|---|---|---|---|---|
| 1 | 17 | 14.6 | 2.4 | 5.76 |
| 2 | 7 | 11.3 | -4.3 | 18.49 |
| 3 | 11 | 8.0 | 3.0 | 9.00 |
| 4 | 2 | 4.7 | -2.7 | 7.29 |
| 5 | 3 | 1.4 | 1.6 | 2.56 |
Summe der quadrierten Residuen: Q(17.9, -3.3) = 43.10
| x | y | ŷ=4+x | Ê=y-ŷ | Ê^2 |
|---|---|---|---|---|
| 1 | 17 | 5 | 12 | 144 |
| 2 | 7 | 6 | 1 | 1 |
| 3 | 11 | 7 | 4 | 16 |
| 4 | 2 | 8 | -6 | 36 |
| 5 | 3 | 9 | -6 | 36 |
Summe der quadrierten Residuen: Q(4, 1) = 233
Die Minimierung der quadrierten Residuensumme sichert, dass jede beliebige andere Gerade eine größere quadrierte Residuensumme liefert. Zur Bestimmung der Kleinste-Quadrate Schätzer setzen wir den Gradienten Null
und lösen das erhaltene lineare Gleichungssystem für die Regressionskoeffizienten und
und erhalten somit die empirische Regressionsgerade
wobei
die empirische Kovarianz bzw. Varianz der Stichprobendaten beschreiben.
Für obiges Tips-Beispiel können wir also die Regressionskoeffizienten einfach aus den statistischen Kennzahlen berechnen.
### Berechnung mittels einfacher Formeln für lineare Regressionsgerade

y = tips.tip
x = tips["total_bill"]

b = x.cov(y) / x.var()
a = y.mean() - b * x.mean()

print("Regressionsgerade: y = a + b x mit Intercept a = %f und slope b = %f (Bestimmtheitsmaß R^2=%f)" %(a,b,x.corr(y)**2))
Regressionsgerade: y = a + b x mit Intercept a = 0.920270 und slope b = 0.105025 (Bestimmtheitsmaß R^2=0.456617)
Natürlich können wir auch direkt mit der Least-Squares Funktion von NumPy Doku für numpy.linalg.lstsq() die kleinste Quadrate Lösung berechnen. Die Erstellung der sogenannten Designmatrix , welche in der ersten Spalte nur aus Einsen und in der zweiten Spalte alle x-Werte (hier Rechnungsdaten) enthält, werden in Abschnitt Lineares Modell für die einfache Regressionsgerade noch genauer besprochen.
#Kleinste-Quadrate via NumPy, siehe
# https://numpy.org/doc/stable/reference/generated/numpy.linalg.lstsq.html
X = np.column_stack((np.ones_like(x), x))
beta, residuals, rank, s = np.linalg.lstsq(X, y, rcond=None)
print("Koeffizienten via least squares: %s, Sum of squared residuals %s" % (beta,residuals[0]))
Koeffizienten via least squares: [0.92026961 0.10502452], Sum of squared residuals 252.78874385077611
Bestimmtheitsma߶
Zur Modellgüte, also wie gut kann das verwendete Modell die Daten tatsächlich erklären, wird häufig das Bestimmtheitsmaß herangezogen, dessen Grundidee wir hier kurz erläutern möchten.
Die Werte schwanken um das arithmetische Mittel und die Frage nach dem Anteil, welcher sich durch das Regressionsmodell mit den Vorhersagewerten erklären lässt, führt auf das Bestimmtheitsmaß. Anstatt der empirischen Varianz aller -Werte betrachten wir die damit sehr eng verbundene Total-Variation (TV) bzw. der Summe der quadratischen Abweichungen (SS)
Mit der Aufteilung können wir die Total-Variation aber wegen
in den grünen Anteil ( Modell-Variation), der die quadratischen Abweichungen von den Modellprognosen zum Mittel entspricht und den roten Anteil ( Residuen-Variation), der die quadrierten Residuen zusammenfasst, splitten denn der Zwischenterm verschwindet wegen sowie
Auch für beliebige lineare Regressionsmodelle gilt die Zerlegung , sofern die Koeffizienten mittels der Methode der kleinsten Quadrate ermittelt werden.
Bestimmtheitsmaß (für beliebige Regression) Das Bestimmtheitsmaß entspricht dem Verhältnis zwischen Modell-Variation und Total-Variation
und gibt damit den Anteil der Gesamtschwankung an, der sich auf das Regressions-Modell zurückführen lässt.
In obigen Tips-Beispiel lautet , d.h. ca. 46 Prozent der Variation der Trinkgeldwerte werden durch das einfache Modell , d.h. den linearen Zusammenhang zur Gesamtrechnung erklärt, und die restlichen 54 Prozent gehen auf die Residuen-Variation zurück. Diese Schwankungen kann also das Modell nicht erklären und haben entweder andere Ursachen, die das Modell nicht erkennt oder die Residuen-Varianz ist allgemein eher groß.
Wegen der Zerlegung der Total-Variation in Modell- und Residuen-Variation folgt dann natürlich sofort
so dass für das Bestimmtheitsmaß immer gilt. Für die lineare Regressionsgerade entsprechen die beiden extremenen Grenzfälle gerade
, d.h. alle liegen auf Geraden wegen , was nur für für alle gelten kann
, d.h. Regressionsgleichung erklärt nichts von der Total-Variation wegen
Außerdem gilt für das Bestimmtheitsmaß der einfachen linearen Regression, bei der ein linearer Zusammenhang zwischen der zu erklärenden Variablen und der univariaten uabhängigen erklärenden Variablen untersucht wird, immer , d.h. das Bestimmtheitsmaß entspricht dem quadrierten Korrelationskoeffizienten
denn aus folgt wieder und somit
Zusammenfassend sehen wir, dass die Berechnung der Regressionskoeffizienten über die Methode der kleinsten Quadrate auf einfach zu implementierende Formeln, die von empirschen Stichprobengrößen der beobachteten Daten abhängen. Insbesondere hängt der Anstieg der Regressionsgeraden von der empirischen Kovarianz bzw. Korrelation ab. Sind die empirische Kovarianz bzw. Korrelation positiv, so ist auch der Regressionskoeffizient ebenfalls positiv und folglich führt eine Erhöhung von auch zu einer Erhöhung des Regressionswertes . Genauer erhalten wir für die Prognose und folglich , d.h. eine Erhöhung von um eine Einheit () führt zur Veränderung um Einheiten für das Regressionsmodell.
Für die Regressionsgerade entspricht das Bestimmtheitsmaß, dass die Modellgüte zur Erklärung der abhängigen Variablen mittels der unabhängigen Variablen für Daten angibt, gerade dem quadrierten Korrelationskoeffizienten und dies zeigt einfach nochmals eine alternative Sichtweise auf die Erfassung des Zusammenhangs zwischen und , denn der Fall ist äquivalent zu einem perfekt linearen Zusammenhang zwischen und , welcher mit der linearen Regressionsgeraden dann natürlich perfekt wiedergegeben wird.
In den folgenden Abschnitten werden wir die Modelle zur Erklärung der unabhängigen Variablen erweitern und aufzeigen, dass die Berechnung für alle linearen Modelle einfach durch Matrix-Vektor Operationen verallgemeinert werden kann. Zudem werden wir viel einfacher diskutieren können, wann das Modell zu einer eindeutigen Lösung führt und in welchen Konstellationen dies nicht möglich ist. Außerdem liefert diese Verallgemeinerung einen umfassenden Überblick über Methoden der induktiven Statistik, so dass für die Regressionskoeffizienten unter gewissen Voraussetzungen Konfidenzintervalle oder statistische Tests abgeleitet werden können.
Lineare Modelle
Bisher wurde in Abschnitt Motivation: Bestimmung der Regressionsgeraden der linearen Regression nur eine Regressionsgerade bestimmt, in dessem zugehörigen Modell die abhängige Variable (Regressand) durch eine unabhängige Variable (Regressor) mittels einer linearen Funktion erklärt wird. Das Konzept der linearen Regression lässt sich allerdings deutlich erweitern, ohne dass die dahinterliegende Mathematik komplizierter wird, so dass beispielsweise auch eine quadratische Funktion den Einfluss von auf erklären kann oder dass mehrere Regressoren Berücksichtigung finden. Wesentlich für diese Modelle ist nur, dass die Regressionskoeffizienten linear sind. Alle diese Regressionsmodelle sind unter dem Begriff lineare Modelle zusammengefassst.
Mathematisch lassen sich alle linearen Modelle, wie beipsielswesie die multivariate lineare Regression oder ANOVA, als schreiben, wobei
Datenmatrix / Designmatrix des Regressors (erklärende / unabhängige Variablen)
Datenvektor des Regressanden (abhängige zu erklärende Variable)
Koeffizientenvektor
Residuenvektor
mit dessen Lösung , die wir im folgenden Abschnitt Kleinste Quadrate Lösung des linearen Modells kurz herleiten werden
man die Prognose für die abhängige Variable für gegebene Daten des Regressors bekommt.
Lineares Modell für die einfache Regressionsgerade
Zur Bestimmung der Regressionsgeraden, die wir in Abschnitt Motivation: Bestimmung der Regressionsgeraden ausführlich diskutiert haben, erhalten wir das lineare Modell wie folgt
Koeffizientenvektor:
Designmatrix: $X =
Datenvektor:
Residuenvektor:
denn entspricht gerade elementweise für alle .
Anmerkung: Üblicherweise modelliert man für die linearen Modelle den Residuenvektor als dimensionalen Zufallsvektor mit und setzt die Beobachtungen der Variablen, die in die Designmatrix eingehen als gegeben (determinstisch) an, so dass dann die Verteilung des Zufallvektors von der Verteilung von des Residuenvektors abhängt. Soll auch als Zufallsvariable modelliert werden, entspricht die Modell-Prognose dem bedingten Erwartungswert .
Lineares Modell für die Anpassung einer polynomiellen Funktion
Für die Bestimmung der quadratischen Regressionsfunktion: stellen wir entsprechend einfaches folgendes lineares Modell auf:
Koeffizientenvektor:
Designmatrix: $X =
Das Aufstellen eines Modells hat also lediglich auf Designmatrix und Koeffizientenvektor Einfluss, so dass die Modelle sehr einfach angepasst werden können. Das Anpassen einer polynomiellen Funktion für das Modell wird einfach durch die modifizierte Designmatrix und Koeffizientenvektor beschrieben.
Lineare Regression mit Prediktoren / Regressoren
Ebenso können wir jetzt mehrere Prediktoren zur Modellierung aufnehmen, so dass
Koeffizientenvektor: und
Designmatrix: $X =
zu wählen sind.
Kleinste Quadrate Lösung des linearen Modells
Wir betrachten das lineare Modell
wobei , () die Designmatrix, der Datenvektor, der unbekannte Koeffizientenvektor und der Residuenvektor ist. Üblicherweise ist Anzahl der Daten . Gesucht ist die Kleinste-Quadrate-(KQ/OLS)-Schätzung
Ableitung der Normalengleichungen
Durch Ausmultiplizieren und Ableiten erhalten wir
Der Gradientenvektor , d.h. der Vektor der partiellen Ableitungen der Residuenquadratsumme , lautet
Setzt man , entstehen die Normalengleichungen
Falls die Designmatrix vollen Spaltenrang hat (), ist invertierbar und es gilt die geschlossene Form
Diese Matrixform verallgemeinert die in Abschnitt Motivation: Bestimmung der Regressionsgeraden hergeleiteten Formeln der einfachen Regression und zeigt gleichzeitig auf, wie wir lineare Regressionsmodelle mittels NumPy einfach selbstständig berechnen können. Mittels der letzten Gleichung folgt für zentrierte Residuen mit und
Mit der kleinste Quadrate Lösung erhalten wir außerdem
wobei den Projektionsoperator auf den linearen Unterraum , der durch die Spalten der Designmatrix aufgespannt wird, und den Projektionsoperator auf den orthogonalen Unterraum .
Folglich erhalten wir
Unter den Standardannahmen der linearen Modell, dass die Residuen aller beobachteten Daten identisch und unabhängig verteilt sind und einer Normalverteilung folgen, reduziert sich die Kovarianzmatrix auf eine Diagonalmatrix mit
erhält man also einfach für die Kovarianzmatrizen
und wegen der Normalverteilungsannahme der Residuen
(iid) folglich für die geschätzten Koeffizienten ebenfalls die multivariate Normalverteilung
welche Grundlage für zahlreiche statistische Tests, die wir in Abschnitt Statistische Tests im linearen Modell näher betrachten, bildet.
Umsetzung mit NumPy
Für obigen Trinkgeld-Datensatz...
#Erzeugen Designmatrix
nx = len(x)
ny = len(y)

if nx==ny:
    n = nx
else:
    print("Achtung: x und y passen nicht zusammen!")

X = np.column_stack((np.ones_like(x), x))
print(X[:5])

#Datenvektor
Y = y
print(Y[:5])
[[ 1. 16.99]
[ 1. 10.34]
[ 1. 21.01]
[ 1. 23.68]
[ 1. 24.59]]
0 1.01
1 1.66
2 3.50
3 3.31
4 3.61
Name: tip, dtype: float64
Lösung des Least-Squares Problems
#least squares
beta, res, rank, s = np.linalg.lstsq(X,Y, rcond= None)

print(beta)
print("sum of squared res: %s, rank(X^T X): %s" % (res[0],rank))
[0.92026961 0.10502452]
sum of squared res: 252.78874385077611, rank(X^T X): 2
#Normalengleichung als lineares Gleichungssystem loesen
A = X.transpose() @ X
b = X.transpose() @ Y
beta2 = np.linalg.solve(A, b)

#print(A)
#print(b)
print(beta2)
[0.92026961 0.10502452]
#mittels inverser beta direkt berechnen
A_inv = np.linalg.inv(A)
beta3 = A_inv @ b
print(beta3)
[0.92026961 0.10502452]
Umsetzung mit Statistik-Paketen
Es gibt zahlreiche Pakete, mit deren Hilfe Regressionsmodelle berechnet werden können. Wir betrachten die folgenden Pakete
Statsmodels
Klassisches Statistik-Framework (ähnlich wie in R): liefert Regressionskoeffizienten, Standardfehler, p-Werte, Konfidenzintervalle, ANOVA, Diagnoseplots und robuste Standardfehler.
Ideal für: wissenschaftliche Statistik, Ökonometrie, Finance, detaillierte Modellanalysesklearn
Machine-Learning-Bibliothek mit Fokus auf Vorhersagemodellen. Schnelle, robuste Implementierung von linearer Regression, aber ohne statistische Tests oder p-Werte.
Ideal für: Vorhersage, ML-Pipelines, skalierbare Modellescipy
Sehr einfache Möglichkeit für eine klassische lineare Regression (y~x). Gibt Steigung, Intercept, r-Wert, p-Wert und Standardfehler zurück – kompakt und leicht zu verwenden.
Ideal für: schnelle Analysen, einfache lineare Zusammenhängelinearmodels (Installation via pip!)
Erweiterte Ökonometrie-Bibliothek: OLS, IV/2SLS, GMM, Fama-MacBeth, Paneldaten (Fixed/Random Effects) und cluster-robuste Fehler.
Ideal für: Finance, Ökonometrie, Paneldatenmodelle, Faktorrecherche (CAPM, Fama-French).
#mittels Paket satsmodels
#https://www.statsmodels.org/dev/generated/statsmodels.regression.linear_model.OLS.html

import statsmodels.api as sm

#Erstellen der Designmatrix
X1 = sm.add_constant(x)

print(X1)

# Modell schaetzen (Kleinste Quadrate = ordinary least squares)
model1 = sm.OLS(Y, X1).fit()

# Ergebnisse anzeigen
print(model1)

print(model1.summary())
     const  total_bill
0      1.0       16.99
1      1.0       10.34
2      1.0       21.01
3      1.0       23.68
4      1.0       24.59
..     ...         ...
239    1.0       29.03
240    1.0       27.18
241    1.0       22.67
242    1.0       17.82
243    1.0       18.78

[244 rows x 2 columns]
<statsmodels.regression.linear_model.RegressionResultsWrapper object at 0x75164ae58350>
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.457
Model:                            OLS   Adj. R-squared:                  0.454
Method:                 Least Squares   F-statistic:                     203.4
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           6.69e-34
Time:                        13:12:43   Log-Likelihood:                -350.54
No. Observations:                 244   AIC:                             705.1
Df Residuals:                     242   BIC:                             712.1
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          0.9203      0.160      5.761      0.000       0.606       1.235
total_bill     0.1050      0.007     14.260      0.000       0.091       0.120
==============================================================================
Omnibus:                       20.185   Durbin-Watson:                   2.151
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               37.750
Skew:                           0.443   Prob(JB):                     6.35e-09
Kurtosis:                       4.711   Cond. No.                         53.0
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
Alternativ kann die Designmatrix auch erstellt werden, indem das Modell mittels Formeln beschrieben wird:
from statsmodels.formula.api import ols

model1_v2 = ols("tip~total_bill", data = tips).fit()

print(model1_v2.summary())

#print(sm.stats.anova_lm(model1_v2))
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.457
Model:                            OLS   Adj. R-squared:                  0.454
Method:                 Least Squares   F-statistic:                     203.4
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           6.69e-34
Time:                        13:12:43   Log-Likelihood:                -350.54
No. Observations:                 244   AIC:                             705.1
Df Residuals:                     242   BIC:                             712.1
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      0.9203      0.160      5.761      0.000       0.606       1.235
total_bill     0.1050      0.007     14.260      0.000       0.091       0.120
==============================================================================
Omnibus:                       20.185   Durbin-Watson:                   2.151
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               37.750
Skew:                           0.443   Prob(JB):                     6.35e-09
Kurtosis:                       4.711   Cond. No.                         53.0
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
X_design = model1_v2.model.exog
#names = model1_v2.model.exog_names

N, p = X_design.shape

print("Dimensionen des linearen Modells: N=%s (sample size), p = %s (model parameters)" % (N,p))
#Designmatrix
print(X_design[:10])
Dimensionen des linearen Modells: N=244 (sample size), p = 2 (model parameters)
[[ 1.   16.99]
 [ 1.   10.34]
 [ 1.   21.01]
 [ 1.   23.68]
 [ 1.   24.59]
 [ 1.   25.29]
 [ 1.    8.77]
 [ 1.   26.88]
 [ 1.   15.04]
 [ 1.   14.78]]
#mittels sklearn
from sklearn.linear_model import LinearRegression
X2 = x.to_numpy().reshape(-1, 1)
model2 = LinearRegression().fit(X2, Y)

print("Intercept:", model2.intercept_)
print("Slope:", model2.coef_[0])
print("R²:", model2.score(X2, Y))
Intercept: 0.9202696135546731
Slope: 0.10502451738435337
R²: 0.45661658635167657
from scipy.stats import linregress

model3 = linregress(x, y)
print(model3)
LinregressResult(slope=np.float64(0.1050245173843534), intercept=np.float64(0.9202696135546726), rvalue=np.float64(0.6757341092113645), pvalue=np.float64(6.692470646863818e-34), stderr=np.float64(0.007364789848762596), intercept_stderr=np.float64(0.15973474637643237))
from linearmodels.iv import IV2SLS

df = pd.DataFrame({"y": y, "x": x})

model4 = IV2SLS.from_formula("y ~ 1 + x", data=df)
results4 = model4.fit()

print(results4.summary)
                            OLS Estimation Summary
==============================================================================
Dep. Variable:                      y   R-squared:                      0.4566
Estimator:                        OLS   Adj. R-squared:                 0.4544
No. Observations:                 244   F-statistic:                    80.349
Date:                Tue, Oct 27 2026   P-value (F-stat)                0.0000
Time:                        13:12:47   Distribution:                  chi2(1)
Cov. Estimator:                robust

                             Parameter Estimates
==============================================================================
            Parameter  Std. Err.     T-stat    P-value    Lower CI    Upper CI
------------------------------------------------------------------------------
Intercept      0.9203     0.2046     4.4985     0.0000      0.5193      1.3212
x              0.1050     0.0117     8.9638     0.0000      0.0821      0.1280
==============================================================================
#via orig. DataFrame
model5 = IV2SLS.from_formula("tip ~ 1 + total_bill", data=tips)
results5 = model5.fit()

print(results5.summary)
                            OLS Estimation Summary
==============================================================================
Dep. Variable:                    tip   R-squared:                      0.4566
Estimator:                        OLS   Adj. R-squared:                 0.4544
No. Observations:                 244   F-statistic:                    80.349
Date:                Tue, Oct 27 2026   P-value (F-stat)                0.0000
Time:                        13:12:47   Distribution:                  chi2(1)
Cov. Estimator:                robust

                             Parameter Estimates
==============================================================================
            Parameter  Std. Err.     T-stat    P-value    Lower CI    Upper CI
------------------------------------------------------------------------------
Intercept      0.9203     0.2046     4.4985     0.0000      0.5193      1.3212
total_bill     0.1050     0.0117     8.9638     0.0000      0.0821      0.1280
==============================================================================
Statistische Tests im linearen Modell
Alle obigen Ausgaben enthalten zusätzliche Informationen zu statistischen Tests, die für das gesamte Modell, die einzelnen Koeffizienten sowie die Residuen durchgeführt werden. Diese Tests basieren auf der Normalverteilungsannahme der unabhängigen und varianzhomogenen Residuen, wie wir am Ende von Abschnitt Kleinste Quadrate Lösung des linearen Modells diskutiert haben.
Wir betrachten hier das 1. Modell, welches mittels ‘statsmodels’ durch Formeln beschrieben wurde etwas genauer
print(model1_v2.summary())
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.457
Model:                            OLS   Adj. R-squared:                  0.454
Method:                 Least Squares   F-statistic:                     203.4
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           6.69e-34
Time:                        13:12:47   Log-Likelihood:                -350.54
No. Observations:                 244   AIC:                             705.1
Df Residuals:                     242   BIC:                             712.1
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      0.9203      0.160      5.761      0.000       0.606       1.235
total_bill     0.1050      0.007     14.260      0.000       0.091       0.120
==============================================================================
Omnibus:                       20.185   Durbin-Watson:                   2.151
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               37.750
Skew:                           0.443   Prob(JB):                     6.35e-09
Kurtosis:                       4.711   Cond. No.                         53.0
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
Die Freiheitsgrade ergeben sich direkt aus dem Modell und können unmittelbar aus der Designmatrix mit (Anzahl der beobachteten Daten) Zeilen und (Anzahl der Modell-Parameter, d.h. Länge des Koeffizienten-Vektors ) abgeleitet werden.
print("Dimensionen des linearen Modells: n = %s (sample size), p = %s (model parameters in beta)" % (N,p))
print("Freiheitsgrade (df): df_resid = %s = n-p, df_model = %s = p-1" % (model1_v2.df_resid, model1_v2.df_model))
Dimensionen des linearen Modells: n = 244 (sample size), p = 2 (model parameters in beta)
Freiheitsgrade (df): df_resid = 242.0 = n-p, df_model = 1.0 = p-1
Die Anova-Tabelle des Modells zeigt die wichtigsten Quadratsummen bzw. davon abgeleitete Mean Squares (Quadratsumme skaliert mit Freiheitsgraden), mit deren Hilfe der Fisher-Test mit der Nullhypothese berechnet wird
print(sm.stats.anova_lm(model1_v2))
               df      sum_sq     mean_sq           F        PR(>F)
total_bill    1.0  212.423733  212.423733  203.357723  6.692471e-34
Residual    242.0  252.788744    1.044582         NaN           NaN
Da die Fisher-Statistik sehr groß ist, ist der entsprechende p-value extrem klein, so dass die Nullhypothese verworfen wird und somit ein signifikanter Nachweis des Modells gegeben ist. Genauer lautet ja die Modell-Prognose , d.h. für gegebenes (hier die Gesamtrechnung) wird für unser Modell, welches auf der einfachen Regressionsgerade basiert somit vorhergesagt. Unter der Nullhpythese, die sich hier wegen nur auf reduziert, würde dann allerdings nur noch die triviale Prognose ergeben. Da die Nullhypthese allerdings verworfen wird, haben wir somit den Nachweis, dass das Modell signifikant zur Erklärung der zu erklärednen Variablen beitragen kann.
Die Tabelle der Regressionskoeffizienten enthält jeweils einen t-Test für , welcher auf der Normalverteilungsannahme der Residuen (sowie deren Unabhängigkeit und Varianzhomogenität), die wir ausführlich in Abschnitt Kleinste Quadrate Lösung des linearen Modells diskutiert haben, und daraus resultierend aus
Die letzte Tabelle der ausführlichen Auswertungstabelle enthält eine Zusammenfassung der Residuen-Auswertung, welche eine Überprüfung obiger Testvoraussetzungen wie der Normalverteilung, Unabhängigkeit und Varianzhomogenität zulassen.
Varianzanalyse (ANOVA) als lineares Modell
Im vorherigen Abschnitt haben wir gesehen, dass bei der Auswertung linearer Modelle ANOVA-Tabellen erzeugt werden. ANOVA steht für Analysis of Variance und basiert auf der Zerlegung der Totalvariation, die wir für Regressionsmodelle bereits diskutiert haben.
Die einfaktorielle ANOVA untersucht den Einfluss einer kategoriellen Variablen mit verschiedenen Ausprägungen auf die metrische Variable . Alle bisher betrachteten linearen Regressions-Modelle hatten nur metrische Variablen als Regressoren bzw. erklärenden Variablen im Modell zur Vorhersage von modelliert. Wir wollen hier nur die Grundidee veranschaulichen und aufzeigen wie sich die ANOVA in das Konzept der linearen Modelle integriert.
Oben haben wir bereits den Einfluss der Gesamtrechnung auf das Trinkgeld mittels eines einfachen linearen Regressionsmodells untersucht und gesehen, dass das Bestimmtheitsmaß beträgt. Somit lassen sich ca. 46 Prozent der Variation der Trinkgeldwertes durch das Modell, welches einen linearen Zusammenhang zur Gesamtrechnung ansetzt, erklären und die verbleibenden 54 Prozent der Schwankung gehen auf die Residuen zurück. Andere Einflussfaktoren auf das gezahlte Trinkgeld, wie beispielsweise die Kundenzufriedenheit mit Service und Essensqualität werden von dem Modell nicht berücksichtigt und können natürlich die Schwankungen zusätzliche beeinflussen, so dass die Residuen automatisch größer werden. Ein statistisches Modell kann natürlich versuchen auch mehrere Einflussfaktoren gleichzeitig aufzunehmen, wenn die Daten dies zulassen. Der Tips-Datensatz enthält neben der Gesamtrechnung und den Trinkgeldern beispielsweise noch den Wochentag und die Information, ob die Gäste mittags oder abends im Restaurant waren.
print(tips.dtypes)total_bill float64
tip float64
sex category
smoker category
day category
time category
size int64
dtype: object
Die folgende Graphik zeigt beispielsweise den Zusammenhang der metrischen Variablen in Abhängigkeit von der Zeit
sns.pairplot(tips, hue="time")<seaborn.axisgrid.PairGrid at 0x7516490a24e0>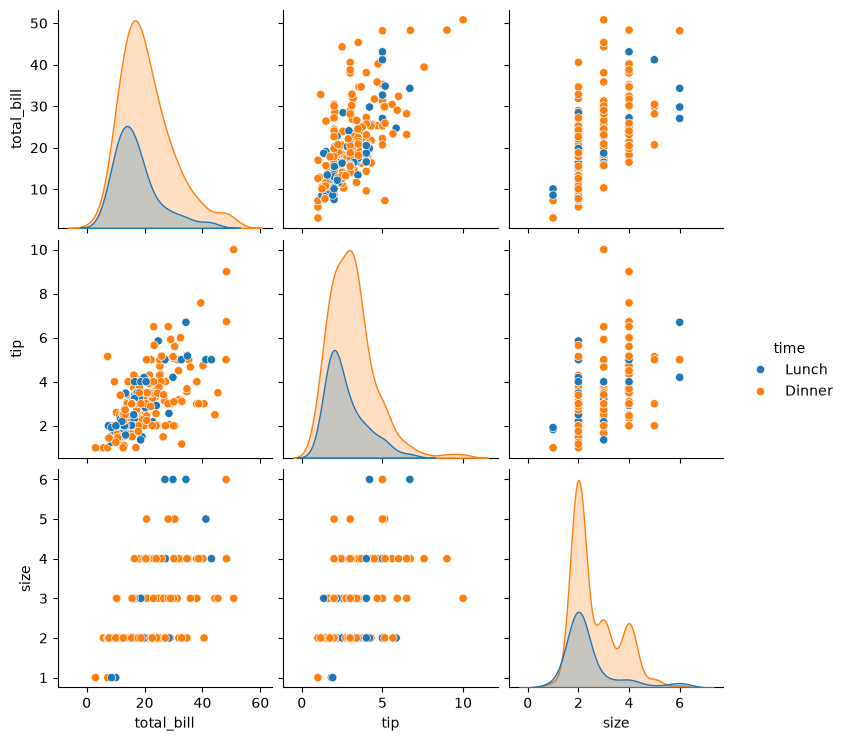
Zur Illustration wie die ANOVA funktioniert, wollen wir jeweils den Einfluss des Wochentags und der Tageszeit auf die gezahlten Trinkgelder betrachten.
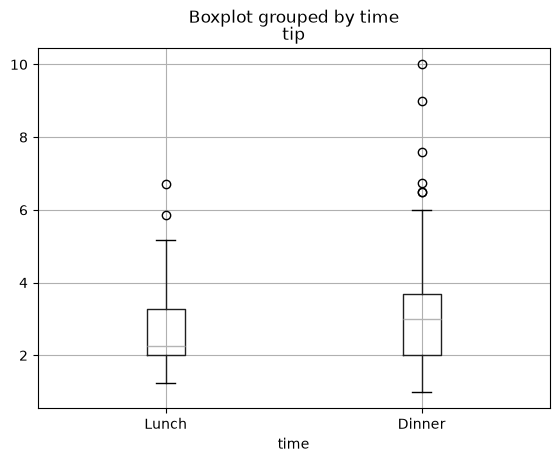
Die folgenden Boxplots visualisieren den Zusammenhang zwischen Trinkgeld und Wochentag bzw. Trinkgeld und Tageszeit.
tips.boxplot(column="tip", by="day")
tips.boxplot(column="tip", by="time")<Axes: title={'center': 'tip'}, xlabel='time'>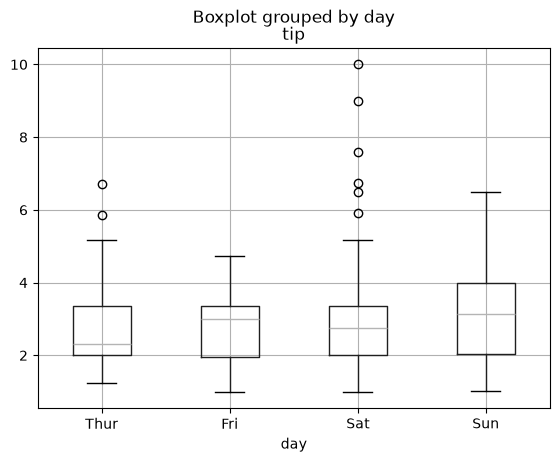
Die relevanten Zahlen zu der können wir natürlich auch einfach berechnen:
tips.groupby("day")["tip"].agg(
count="count",
mean="mean",
std="std",
var="var",
q25=lambda x: x.quantile(0.25),
median="median",
q75=lambda x: x.quantile(0.75),
)
tips.groupby("time")["tip"].agg(
count="count",
mean="mean",
std="std",
var="var",
q25=lambda x: x.quantile(0.25),
median="median",
q75=lambda x: x.quantile(0.75),
)Die Werte und die Boxplots zeigen, dass beide Faktoren einen leichten Einfluss auf die Trinkgelder haben könnten. Eine objektive Entscheidung, ob die Unterschiede nur zufällig oder wirklich systematisch sind, kann mittels ANOVA statistisch beantwortet werden.
Im ersten Beispiel sehen wir und im zweiten Beispiel Gruppen.
Allgemein können die Daten für die einfaktorielle Varianzanalyse mit insgesamt Daten aus den Gruppen wie folgt übersichtlich gruppenweise dargestellt werden.
| Stichprobe | Index | Gruppe 1 | Gruppe 2 | … | Gruppe m |
|---|---|---|---|---|---|
| 1 | … | ||||
| 2 | … | ||||
| ⋮ | ⋮ | ⋮ | ⋱ | ⋮ | |
| … | |||||
| Gruppenmittel | … | ||||
| Gesamtmittel |
Der Index stellt die Stichprobenwerte der ersten Gruppe, hier also dem Wochentag Thur / Do dar, alle TRinkgelder für Freitag usw. Allgemein beschreibt der Wert also im ersten Beispiel das Trinkgeld des -ten Gastes am -ten Tag.
Varianzzerlegung der ANOVA
Das statistische Modell der ANOVA für den -ten Messwert der -ten Gruppe als Zufallsvariable
mit unabhängigen und identisch verteilten überlagerten Fehlerterm dar, so dass und folglich die Prognose mit dem Gruppenmittel entspricht.
Die Varianzanalyse basiert auf der Zerlegung der Gesamtvariation der abhängigen Variablen, hier also den Trinkgeldern in einen Modell-Anteil, genauer die Variation, die auf den Faktor, welchen wir einfach mit bezeichnen werden (Variation zwischen den Gruppen) und den Residuen-Anteil (Variation innerhalb der Gruppen), ähnlich wie wir es bei der Herleitung des Bestimmtheitsmaßes gesehen haben.
Unter der Nullhypothese und obiger Annahme unabhängiger und normalverteilter Fehlerterme mit homogenen Varianzen ( hängt also nicht von Gruppe ab) besitzt die Testgröße
eine Fisher-Verteilung. Hat der Faktor und somit das Modell einen großen Einfluß auf die erklärende Variable , so werden die Gruppenmittelwerte sich stark unterscheiden, so dass die Quadratsummen des Faktors groß sind. Hat hingegen der Faktor keinen wesentlichen Einfluss ist die Schwankung innerhalb der Gruppen deutlich größer. Große Testwerte sprechen also gegen die Nullhypothese. Ist der entsprechende p-Value kleiner als die vorgegebene Irrtumswahtscheinlichkeit , die wir hier einfach mit 5% ansetzen, wird verworfen und stattdessen die Alternativhypothese angenommen. Diese besagt, dass es mindestens einen Mittelwert-Unterschied gibt.
Ähnlich sieht es bei UNtersuchungen nach dem Einfluss des Wochentags aus.
#import statsmodels.api as sm
from statsmodels.formula.api import ols
model_day = ols("tip ~ C(day)", data=tips).fit()
anova_day = sm.stats.anova_lm(model_day, typ=1)
anova_dayBei 5%-tiger Irrtumswahrscheinlichkeit hat der Test, der den Einfluss des Wochentags auf das Trinkgeld untersucht, keine Einwände gegen die Nullhypothese , da der p-Value die Irrtumswahrscheinlichkeit überschreitet. Somit kann die Alternativhypothese, dass sich die gezahlten Trinkgelder mindestens zwischen zwei verschiedenen Wochentagen unterscheiden () nicht statistisch signifikant nachgewiesen werden. Der Wochentag hat also keinen Einfluss auf die durchschnittlich gezahlten Trinkgelder.
model_time = ols("tip ~ C(time)", data=tips).fit()
anova_time = sm.stats.anova_lm(model_time, typ=1)
print(anova_time)
#fuer bereits als kategorielle Daten initierte Variablen kann C() auch weggelassen werden
print(tips.dtypes)
model_time2 = ols("tip ~ time", data=tips).fit()
anova_time2 = sm.stats.anova_lm(model_time2, typ=1)
print(anova_time2) df sum_sq mean_sq F PR(>F)
C(time) 1.0 6.882181 6.882181 3.633815 0.057802
Residual 242.0 458.330296 1.893927 NaN NaN
total_bill     float64
tip            float64
sex           category
smoker        category
day           category
time          category
size             int64
dtype: object
df sum_sq mean_sq F PR(>F)
time 1.0 6.882181 6.882181 3.633815 0.057802
Residual 242.0 458.330296 1.893927 NaN NaN
Bei 5%-tiger Irrtumswahrscheinlichkeit hat der Test, der den Einfluss der Tageszeit auf das Trinkgeld untersucht, keine Einwände gegen die Nullhypothese , da der p-Value die Irrtumswahrscheinlichkeit überschreitet. Somit kann die Alternativhypothese, dass sich die gezahlten Trinkgelder zwischen Lunch und Dinner unterscheiden () nicht statistisch signifikant nachgewiesen werden.
Bei dem Vergleich der Mittelwerte von genau 2 Gruppen, führt man üblicherweise einen doppelten t-Test durch, der zumindest für zweiseitige Tests allerdings exakt mit der ANOVA übereinstimmt, da die Testgröße der ANOVA wegen mit der quadrierten Testgröße des t-Tests übereinstimmt.
Hat man eine signifikante ANOVA durchgeführt, interessiert natürlich zwischen welchen Gruppen konkret der Mittelwertunterschied auftritt. Dies beantwort die klassische ANOVA-Auswertung allerdings nicht und klassischerweise führt man dann paarweise Mittelwertvergleiche durch. Für Gruppen ergeben sich allerdings Vergleiche und somit automatisch zur Problematik des multiplen Testens.
Eine Interessante Alternative zu klassischen PostHoc-Mittelwertvergleichen liefert allerdings die Auswertung des zugehörigen linearen Modells, dass sich durch Einführung von Dummy-Variablen ergibt.
Dummy-Kodierung der Faktorvariablen
Das statistische Modell der einfaktoriellen ANOVA beschreibt den -ten Messwert der -ten Gruppe kann durch Einführung von Dummy-Variablen, deren Werte fast immer Null sind
auch als Regressionsmodell geschrieben werden. Da jeder Datenpunkt sich zu genau einer Gruppe zuordnen lässt, summieren sich die Dummyvariablen jeweils zu 1. Daher genügen wegen tatsächlich sogar Dummyvariablen
Damit können wir die ANOVA als lineares Modell mit dem Beobachtungsvektor
der künstlichen Designmatrix , also der Matrix der Dummyvariablen, dem unbekannten Vektor der Modellparameter
und dem ebenfalls unbekannten Fehlervektor
schreiben. Die Auswertung des linearen Modells gibt neben der klassischen Varianzzerlegung zusätzliche Mittelwertvergleiche, da mit Ausnahme des Intercepts die restlichen Koeffizienten wegen , usw. gerade den Vergleich der Gruppenmittelwerte bzw. Gruppeneffekte zur Referenzgruppe bechreiben und geschätzt werden. Die zugehörigen t-Tests untersuchen jeweils die Hypothesen , was äquivalent zu bzw. ist.
#model_day = ols("tip ~ C(day)", data=tips).fit()
print(model_day.summary())
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.020
Model:                            OLS   Adj. R-squared:                  0.008
Method:                 Least Squares   F-statistic:                     1.672
Date:                Tue, 27 Oct 2026   Prob (F-statistic):              0.174
Time:                        13:12:49   Log-Likelihood:                -422.43
No. Observations:                 244   AIC:                             852.9
Df Residuals:                     240   BIC:                             866.8
Df Model:                           3
Covariance Type:            nonrobust
=================================================================================
                    coef    std err          t      P>|t|      [0.025      0.975]
---------------------------------------------------------------------------------
Intercept         2.7715      0.175     15.837      0.000       2.427       3.116
C(day)[T.Fri]    -0.0367      0.361     -0.102      0.919      -0.748       0.675
C(day)[T.Sat]     0.2217      0.229      0.968      0.334      -0.229       0.673
C(day)[T.Sun]     0.4837      0.236      2.051      0.041       0.019       0.948
==============================================================================
Omnibus:                       82.801   Durbin-Watson:                   1.962
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              238.276
Skew:                           1.492   Prob(JB):                     1.82e-52
Kurtosis:                       6.811   Cond. No.                         5.28
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
print(model_time.summary()) OLS Regression Results
==============================================================================
Dep. Variable: tip R-squared: 0.015
Model: OLS Adj. R-squared: 0.011
Method: Least Squares F-statistic: 3.634
Date: Tue, 27 Oct 2026 Prob (F-statistic): 0.0578
Time: 13:12:49 Log-Likelihood: -423.13
No. Observations: 244 AIC: 850.3
Df Residuals: 242 BIC: 857.3
Df Model: 1
Covariance Type: nonrobust
=====================================================================================
coef std err t P>|t| [0.025 0.975]
-------------------------------------------------------------------------------------
Intercept 2.7281 0.167 16.347 0.000 2.399 3.057
C(time)[T.Dinner] 0.3746 0.197 1.906 0.058 -0.012 0.762
==============================================================================
Omnibus: 77.962 Durbin-Watson: 1.958
Prob(Omnibus): 0.000 Jarque-Bera (JB): 206.982
Skew: 1.437 Prob(JB): 1.13e-45
Kurtosis: 6.479 Cond. No. 3.56
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
Die Auswertung des linearen Modells gibt Aufschluss über die Mittelwertdifferenzen im Vergleich zur Referenzruppe. Der Intercept der in der letzten Tabelle zeigt beispielsweise, dass das durchschnittliche Trinkgeld in der Referenzgruppe (Lunch) bei 2.7281 liegt und in der zweiten Gruppe (Dinner) durchschnittlich um 0.3746 höher ist. Allerdings ist dieser Unterschied, wie bereits bei der ANOVA_Auswertung gesehen, nicht statistisch signifikant, da der p-Value für den Test nicht ausreicht, um die Nullhypothese bei 5%-iger Irrtumswahrscheinlichkeit zu verwerfen.
ANOVA vs. lineare Regression
Sowohl die klassischen Regressionsmodelle als auch die ANOVA zählen zu den linearen Modellen und können somit auch in Python nahezu identisch umgesetzt werden. Allerdings soll am Beispiel der Analyse vom Einfluss der Tischgröße auf das Trinkgeld kurz der Unterschied zwischen beiden Verfahren nochmals veranschaulicht werden. Die Prognose im Falle der einfachen lineare Regression zeigt, dass sich mit jedem zusätzlichen Gast am Tisch das durchschnittliche Trinkgeld um 0.7118 Dollar erhöht.
# einfache lineare Regression: Trinkgeld ~ Tischgroesse
sns.lmplot(data=tips, x="size", y="tip")
plt.title("Lineare Regression: Tip ~ size")
plt.show()
#Standard Regression mit metrischer Variable size

model1 = ols("tip ~ size", data=tips).fit()

anova_table1 = sm.stats.anova_lm(model1, typ=1)
print(anova_table1)
print(model1.summary())
             df      sum_sq     mean_sq          F        PR(>F)
size        1.0  111.378050  111.378050  76.175426  4.300543e-16
Residual  242.0  353.834427    1.462126        NaN           NaN
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.239
Model:                            OLS   Adj. R-squared:                  0.236
Method:                 Least Squares   F-statistic:                     76.18
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           4.30e-16
Time:                        13:12:49   Log-Likelihood:                -391.56
No. Observations:                 244   AIC:                             787.1
Df Residuals:                     242   BIC:                             794.1
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept      1.1691      0.223      5.233      0.000       0.729       1.609
size           0.7118      0.082      8.728      0.000       0.551       0.872
==============================================================================
Omnibus:                       81.369   Durbin-Watson:                   1.820
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              273.339
Skew:                           1.393   Prob(JB):                     4.42e-60
Kurtosis:                       7.373   Cond. No.                         8.85
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
Die Testgröße der zuhörigen Varianzanalyse, die testet, beträgt und führt zu einem extrem kleinen p-Value, so dass wir hier den signifikanten Nachweis der Alternativhypothese haben.
Obige Graphik zeigt allerdings, dass die Anzahl der Gäste ein diskretes Merkmal ist, welches wir auch als katgorielle Variable interpretieren können und somit eine ANOVA durchführen können, um zu untersuchen, ob sich das mittlere Trinkgeld über die verschiedenenen Gruppen unterscheidet.
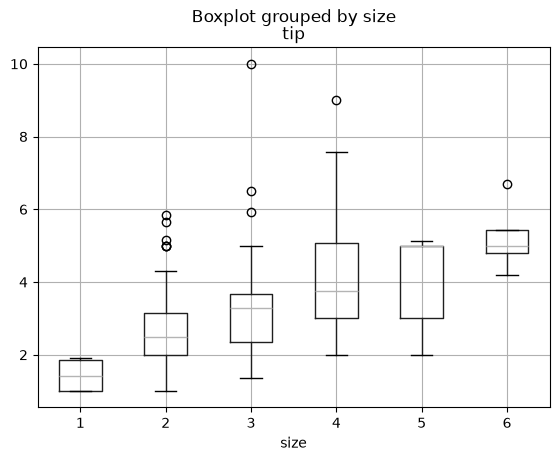
Genauer lautet für die klassische ANOVA die Nullhypothese . Der folgende Boxplot zeigt, dass die Daten nicht für diese Hypothese sprechen.
Der Python-Code zur Berechnung des 2. Modells unterscheidet sich nur durch die Kodierung, dass die Variable size durch C(size) als Faktor interpretiert werden soll.
tips.boxplot(column="tip", by="size")

tips.groupby("size")["tip"].agg(
    count="count",
    mean="mean",
    median="median",
    std="std",
    var="var",
)
#Anova = Regression mit dummy-Variablen fuer kategorielle Daten (1. Kategorie (size = 1)) als Referenzgruppe
model2 = ols("tip ~ C(size)", data=tips).fit()

anova_table2 = sm.stats.anova_lm(model2, typ=1)
print(anova_table2)
print(model2.summary())
df sum_sq mean_sq F PR(>F)
C(size) 5.0 115.640313 23.128063 15.746331 2.169463e-13
Residual 238.0 349.572164 1.468791 NaN NaN
OLS Regression Results
==============================================================================
Dep. Variable: tip R-squared: 0.249
Model: OLS Adj. R-squared: 0.233
Method: Least Squares F-statistic: 15.75
Date: Tue, 27 Oct 2026 Prob (F-statistic): 2.17e-13
Time: 13:12:49 Log-Likelihood: -390.09
No. Observations: 244 AIC: 792.2
Df Residuals: 238 BIC: 813.2
Df Model: 5
Covariance Type: nonrobust
================================================================================
coef std err t P>|t| [0.025 0.975]
--------------------------------------------------------------------------------
Intercept 1.4375 0.606 2.372 0.018 0.244 2.631
C(size)[T.2] 1.1448 0.614 1.865 0.063 -0.064 2.354
C(size)[T.3] 1.9557 0.637 3.070 0.002 0.701 3.211
C(size)[T.4] 2.6979 0.638 4.229 0.000 1.441 3.955
C(size)[T.5] 2.5905 0.813 3.186 0.002 0.989 4.192
C(size)[T.6] 3.7875 0.857 4.420 0.000 2.099 5.476
==============================================================================
Omnibus: 77.409 Durbin-Watson: 1.807
Prob(Omnibus): 0.000 Jarque-Bera (JB): 244.825
Skew: 1.344 Prob(JB): 6.87e-54
Kurtosis: 7.106 Cond. No. 24.2
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
Der Testwert des Fisher-Tests ist im 2. Modell und führt ebenso zur Verwerfung der Nullhypothese und somit zum signifikanten Nachweis der Alternativhypothese, dass sich mind. ein Unterschied zwischen den Gruppen findet. Eine Auswertung des linearen Modells zeigt mit das durchschnittliche Trinkgeld für einzelne Gäste an. Die restlichen Koeffizienten für zeigt hingegen die Unterschiede der jeweils zur 1. Referenzgruppe auf. Die zugeöhrigen Tests mit fallen alle signifikant aus, so dass hier der statistische Nachweis, dass sich alle Gruppenmittel (2er Tisch, 3er Tisch, .. , 6er Tisch) sich vom durchschnittlichen Trinkgeld von 1er Tischen unterscheiden. Beide Modelle untersuchen demnach ähnliche, aber prinzipiell verschiedene Fragestellungen mit entsprechend unterschiedlichen Hypothesen. Ein Vergleich der Designmatrizen sowie der Freiheitsgrade beider Modelle verdeutlicht dies nochmals.
Vergleich der Designmatrizen
X1_design = model1.model.exog

N1, m1 = X1_design.shape
print("lineare Regression Modell-Dimension: N=%s (sample size), m=%s (model)" % (N1,m1))
print("Freiheitsgrade (df):\ndf_resid:", model1.df_resid, " = N - m =", N1 - m1, "df_model:", model1.df_model, "= m-1 =",m1-1)

print(X1_design[:10])
lineare Regression Modell-Dimension: N=244 (sample size), m=2 (model)
Freiheitsgrade (df):
df_resid: 242.0 = N - m = 242 df_model: 1.0 = m-1 = 1
[[1. 2.]
[1. 3.]
[1. 3.]
[1. 2.]
[1. 4.]
[1. 4.]
[1. 2.]
[1. 4.]
[1. 2.]
[1. 2.]]
X2_design = model2.model.exog

N2, m2 = X2_design.shape
print("ANOVA Modell-Dimension: N=%s (sample size), m=%s (model)" % (N2,m2))
print("Freiheitsgrade (df):\ndf_resid:", model2.df_resid, " = N - m =", N2 - m2, "df_model:", model2.df_model, "= m-1 =",m1-1)

print(X2_design[:10])
ANOVA Modell-Dimension: N=244 (sample size), m=6 (model)
Freiheitsgrade (df):
df_resid: 238.0 = N - m = 238 df_model: 5.0 = m-1 = 1
[[1. 1. 0. 0. 0. 0.]
[1. 0. 1. 0. 0. 0.]
[1. 0. 1. 0. 0. 0.]
[1. 1. 0. 0. 0. 0.]
[1. 0. 0. 1. 0. 0.]
[1. 0. 0. 1. 0. 0.]
[1. 1. 0. 0. 0. 0.]
[1. 0. 0. 1. 0. 0.]
[1. 1. 0. 0. 0. 0.]
[1. 1. 0. 0. 0. 0.]]
Wie üblich gibt es natürlich mehrere Möglichkeiten sich die Designmatrix zu erstellen und wir zeigen hier eine Alternative
import patsy

y_Data, Design = patsy.dmatrices("tip ~ size", data=tips)

#print(y_Data)
print(Design[:10])
[[1. 2.]
[1. 3.]
[1. 3.]
[1. 2.]
[1. 4.]
[1. 4.]
[1. 2.]
[1. 4.]
[1. 2.]
[1. 2.]]
Mittels der Treatment() Option, kann die Referenzgruppe auch einfach angepasst werden, dann ändert sich insbesondere das lineare Modell, da sich Koeffizienten-Vektor und Designmatrix ändern und folglich auch die untersuchten Hypothesen anpassen.
model2_b = ols("tip ~ C(size, Treatment(reference=4))", data=tips).fit()

print(model2_b.summary())

print(model2_b.model.exog[:10])
OLS Regression Results
==============================================================================
Dep. Variable: tip R-squared: 0.249
Model: OLS Adj. R-squared: 0.233
Method: Least Squares F-statistic: 15.75
Date: Tue, 27 Oct 2026 Prob (F-statistic): 2.17e-13
Time: 13:12:50 Log-Likelihood: -390.09
No. Observations: 244 AIC: 792.2
Df Residuals: 238 BIC: 813.2
Df Model: 5
Covariance Type: nonrobust
========================================================================================================
coef std err t P>|t| [0.025 0.975]
--------------------------------------------------------------------------------------------------------
Intercept 4.1354 0.199 20.756 0.000 3.743 4.528
C(size, Treatment(reference=4))[T.1] -2.6979 0.638 -4.229 0.000 -3.955 -1.441
C(size, Treatment(reference=4))[T.2] -1.5531 0.222 -7.008 0.000 -1.990 -1.117
C(size, Treatment(reference=4))[T.3] -0.7422 0.280 -2.652 0.009 -1.294 -0.191
C(size, Treatment(reference=4))[T.5] -0.1074 0.577 -0.186 0.853 -1.245 1.030
C(size, Treatment(reference=4))[T.6] 1.0896 0.638 1.708 0.089 -0.167 2.346
==============================================================================
Omnibus: 77.409 Durbin-Watson: 1.807
Prob(Omnibus): 0.000 Jarque-Bera (JB): 244.825
Skew: 1.344 Prob(JB): 6.87e-54
Kurtosis: 7.106 Cond. No. 11.2
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
[[1. 0. 1. 0. 0. 0.]
[1. 0. 0. 1. 0. 0.]
[1. 0. 0. 1. 0. 0.]
[1. 0. 1. 0. 0. 0.]
[1. 0. 0. 0. 0. 0.]
[1. 0. 0. 0. 0. 0.]
[1. 0. 1. 0. 0. 0.]
[1. 0. 0. 0. 0. 0.]
[1. 0. 1. 0. 0. 0.]
[1. 0. 1. 0. 0. 0.]]
Der folgende Code zeigt den Einfluss des Modells, welcher durch die Eränzung -1 in der Formel den Intercept entfernt. Dann entsprechen die Koeffizienten nur noch den Gruppenmittelwerten und die Auswertung des linearen Modelles passt sich entsprechend an.
model_2c = ols("tip ~ C(size) - 1", data=tips).fit()

print(model_2c.summary())

print(model_2c.model.exog[:10])
OLS Regression Results
==============================================================================
Dep. Variable: tip R-squared: 0.249
Model: OLS Adj. R-squared: 0.233
Method: Least Squares F-statistic: 15.75
Date: Tue, 27 Oct 2026 Prob (F-statistic): 2.17e-13
Time: 13:12:50 Log-Likelihood: -390.09
No. Observations: 244 AIC: 792.2
Df Residuals: 238 BIC: 813.2
Df Model: 5
Covariance Type: nonrobust
==============================================================================
coef std err t P>|t| [0.025 0.975]
------------------------------------------------------------------------------
C(size)[1] 1.4375 0.606 2.372 0.018 0.244 2.631
C(size)[2] 2.5823 0.097 26.613 0.000 2.391 2.773
C(size)[3] 3.3932 0.197 17.259 0.000 3.006 3.780
C(size)[4] 4.1354 0.199 20.756 0.000 3.743 4.528
C(size)[5] 4.0280 0.542 7.432 0.000 2.960 5.096
C(size)[6] 5.2250 0.606 8.623 0.000 4.031 6.419
==============================================================================
Omnibus: 77.409 Durbin-Watson: 1.807
Prob(Omnibus): 0.000 Jarque-Bera (JB): 244.825
Skew: 1.344 Prob(JB): 6.87e-54
Kurtosis: 7.106 Cond. No. 6.24
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
[[0. 1. 0. 0. 0. 0.]
[0. 0. 1. 0. 0. 0.]
[0. 0. 1. 0. 0. 0.]
[0. 1. 0. 0. 0. 0.]
[0. 0. 0. 1. 0. 0.]
[0. 0. 0. 1. 0. 0.]
[0. 1. 0. 0. 0. 0.]
[0. 0. 0. 1. 0. 0.]
[0. 1. 0. 0. 0. 0.]
[0. 1. 0. 0. 0. 0.]]
Zu beachten ist, dass die Varianzzerlegung, welche den Einfluss des Faktors auf die zu erklärente Variable untersucht, von der konkreten Dummy-Kodierung und somit Modellwahl unabhängig ist.
Mehrfaktorielle ANOVA
Möchte man mehrere Faktoren im Modell berücksichtigen, wird eine mehrfaktorielle Varianzanalyse angewendet, die zusätzliche noch die Wechselwirkungen (Interaktionen) zwischen den Faktoren berücksichtigen kann, welche in der Regel allerdings, die Interpretierbarkeit deutlich verkompliziert, falls sie tatsächliche vorhanden sind. Dies soll allerdings hier nicht weiter thematisiert werden.
Beim Formulieren eines statistischen Modells zur Vorhersage von können wir nun natürlich sowohl kategorielle Variablen (Faktoren) als auch metrische Variablen und deren Transformationen sowie die Interaktionen zwischen den einzelnen Variablen berücksichtigen. Das + in der Formel wird immer als ein additives Hinzufügen zum Modell interpretiert, während der Oprator * als Interaktionsoperator zu verstehen ist. Möchte man beispielsweise eine quadrierte Variable bzw. im Modell berücksichtigen, ergänzt man die Formel um bzw. . Somit ist die Umsetzung komplexer linearer Modelle sehr einfach zu implemntieren.
Dies beeinflusst natürlich die Designmatrix sowie den Koeffizientenvektor und folglich auch die zugehörigen Tests für . Insbesondere Interaktionenen verkomplizeren allerdings die Interpretationen der Koeffizientenauswertungen und wir verweisen an dieser Stelle auf die Literatur, z.B. Kutner (2005) (Link)
In der Finance-Literatur wird fast nie von einer ANOVA gesprochen, sondern weil die ANOVA ein Spezialfall eines linearen Modells darstellt einfach nur von Linearen Faktor-Modellen mit Interaktionen gesprochen.
# Vollständiges Modell mit Interaktionen

model_full1 = ols(
    "tip ~ total_bill + size + C(time) + C(day) + C(day)*C(time)",
    data=tips
).fit()

print(model_full1.summary())
                            OLS Regression Results
==============================================================================
Dep. Variable:                    tip   R-squared:                       0.469
Model:                            OLS   Adj. R-squared:                  0.454
Method:                 Least Squares   F-statistic:                     29.82
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           2.45e-29
Time:                        13:12:50   Log-Likelihood:                -347.64
No. Observations:                 244   AIC:                             711.3
Df Residuals:                     236   BIC:                             739.3
Df Model:                           7
Covariance Type:            nonrobust
===================================================================================================
                                      coef    std err          t      P>|t|      [0.025      0.975]
---------------------------------------------------------------------------------------------------
Intercept                           0.6621      0.221      2.995      0.003       0.227       1.098
C(time)[T.Dinner]                   0.2142      1.032      0.208      0.836      -1.819       2.248
C(day)[T.Fri]                       0.1500      0.410      0.366      0.715      -0.658       0.958
C(day)[T.Sat]                      -0.1292      0.515     -0.251      0.802      -1.143       0.885
C(day)[T.Sun]                      -0.0737      0.516     -0.143      0.886      -1.090       0.942
C(day)[T.Fri]:C(time)[T.Dinner]    -0.3234      1.141     -0.283      0.777      -2.572       1.925
C(day)[T.Sat]:C(time)[T.Dinner]    -0.1292      0.515     -0.251      0.802      -1.143       0.885
C(day)[T.Sun]:C(time)[T.Dinner]    -0.0737      0.516     -0.143      0.886      -1.090       0.942
total_bill                          0.0932      0.009      9.974      0.000       0.075       0.112
size                                0.1870      0.088      2.132      0.034       0.014       0.360
==============================================================================
Omnibus:                       25.810   Durbin-Watson:                   2.097
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               48.438
Skew:                           0.566   Prob(JB):                     3.03e-11
Kurtosis:                       4.867   Cond. No.                     3.62e+17
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
[2] The smallest eigenvalue is 8.93e-31. This might indicate that there are
strong multicollinearity problems or that the design matrix is singular.
/tmp/ipykernel_801209/301128488.py:6: SingularMatrixWarning: The design matrix is rank-deficient. The model parameters are not uniquely determined.
  ).fit()
Regression für Zeitreihen
Achtung: die Annahmen von unabhängigen und identisch verteilten Residuen für obige lineare Modelle ist für Zeitreihen im Allgemeinen nicht mehr gegeben. Sowohl die Zeitabhängigkeit als auch Nichtstationarität müssen entsprechend gehandelt werden. Häufig ist es sinnvoll die Zeitreihen beispielsweise durch Differenzenbildung in stationäre Zeitreihen zu überführen. Dies haben wir auch beim Übergang vpn Aktienkursen zu Renditen bzw. Returns durchgeführt. Außerdem sollte immer eine Analyse der Autokovarianzfunktion vor der Regression durchgeführt werden.
siehe Literatur: Stock & Watson (2020), Hamilton (1994), Enders (2015), Campbell et al. (1997) oder Shumway & Stoffer (2017)
Multiple Regression
Die multiple lineare Regression ist ein statistisches Verfahren zur Untersuchung des linearen Zusammenhangs zwischen einer abhängigen Variable und mehreren unabhängigen Variablen. Im Gegensatz zur einfachen linearen Regression ermöglicht sie es, den Einfluss mehrerer erklärender Variablen gleichzeitig zu berücksichtigen. Dadurch kann der Zusammenhang zwischen einer einzelnen unabhängigen Variable und der abhängigen Variable unter Konstanthaltung der übrigen Einflussgrößen analysiert werden.
Das allgemeine Modell der multiplen linearen Regression lautet:
Dabei bezeichnet die abhängige Variable der Beobachtung , während die unabhängigen Variablen darstellen.
Der Parameter ist der Achsenabschnitt (Intercept) und beschreibt den erwarteten Wert von , wenn alle unabhängigen Variablen den Wert null annehmen.
Die Regressionskoeffizienten geben an, um wie viele Einheiten sich der erwartete Wert der abhängigen Variable bei einer Erhöhung der jeweiligen unabhängigen Variable um eine Einheit verändert, während alle anderen Variablen konstant gehalten werden.
Der Fehlerterm erfasst die durch das Modell nicht erklärten Einflüsse auf die abhängige Variable.
Schätzung der Regressionskoeffizienten und Residuen
Während die Werte für und direkt aus den Datensätzen stammen, müssen die Regressionskoeffizienten und die Fehlerterme geschätzt werden.
1. Schätzung der Regressionskoeffizienten 
Die Regressionskoeffizienten werden üblicherweise mithilfe der Methode der kleinsten Quadrate (Ordinary Least Squares, OLS) geschätzt. Dabei werden diejenigen Koeffizienten bestimmt, welche die Summe der quadrierten Abweichungen zwischen den beobachteten und den vorhergesagten Werten minimieren.
Die Schätzung erfolgt über:
Dabei bezeichnet den Vektor der geschätzten Regressionskoeffizienten. Voraussetzung für diese Berechnung ist, dass die Matrix invertierbar ist.
2. Berechnung der Residuen 
Nachdem die Regressionskoeffizienten geschätzt wurden, lassen sich zunächst die vorhergesagten Werte der abhängigen Variable berechnen:
Die Residuen ergeben sich anschließend als Differenz zwischen den tatsächlich beobachteten und den vorhergesagten Werten:
Durch Einsetzen der vorhergesagten Werte ergibt sich:
Die theoretischen Fehlerterme sind nicht direkt beobachtbar. Stattdessen werden die berechneten Residuen als Schätzungen dieser Fehlerterme verwendet.
Somit werden zunächst aus den beobachteten Daten und die Regressionskoeffizienten mittels OLS geschätzt. Anschließend werden daraus die vorhergesagten Werte und die Residuen berechnet.
Statistische Überprüfung der Modellannahmen
Die Anwendung der linearen Regression und der Varianzanalyse (ANOVA) setzt bestimmte statistische Modellannahmen voraus. Um die Aussagekraft der geschätzten Regressionskoeffizienten und der durchgeführten Signifikanztests beurteilen zu können, werden diese Annahmen anhand geeigneter statistischer Tests und grafischer Verfahren überprüft.
Im Rahmen der vorliegenden Untersuchung werden die Normalverteilung der Residuen, die Homoskedastizität, die Unabhängigkeit der Beobachtungen beziehungsweise Fehlerterme sowie die Linearität der Zusammenhänge untersucht. Bei der multiplen linearen Regression wird zusätzlich eine Prüfung auf Multikollinearität durchgeführt.
Für die statistischen Hypothesentests wird ein Signifikanzniveau von festgelegt. Die Entscheidungsregel lautet:
: Die Nullhypothese wird verworfen.
: Die Nullhypothese kann nicht verworfen werden.
Ein nicht signifikanter Test bestätigt die jeweilige Nullhypothese jedoch nicht endgültig, sondern bedeutet lediglich, dass auf Grundlage der vorliegenden Daten keine ausreichenden Hinweise gegen sie bestehen.
1. Prüfung der Normalverteilung
Die Normalverteilungsannahme wird mithilfe des Shapiro-Wilk-Tests sowie einer grafischen Untersuchung der Residuen überprüft.
Bei der linearen Regression bezieht sich die Normalverteilungsannahme auf die Fehlerterme und nicht unmittelbar auf die abhängige oder die unabhängigen Variablen. Da die theoretischen Fehlerterme nicht beobachtbar sind, werden die geschätzten Residuen untersucht.
Auch bei der einfaktoriellen ANOVA bezieht sich die Normalverteilungsannahme auf die Fehler innerhalb der einzelnen Gruppen. Hierzu können die Abweichungen der Beobachtungen von ihren jeweiligen Gruppenmittelwerten betrachtet werden.
1.1 Shapiro-Wilk-Test
Der Shapiro-Wilk-Test untersucht, ob die vorliegenden Residuen mit einer Normalverteilung vereinbar sind.
Die Hypothesen lauten:
Nullhypothese:
Die Fehlerterme folgen einer Normalverteilung.
Alternativhypothese:
Die Teststatistik des Shapiro-Wilk-Tests wird mit bezeichnet:
Dabei bezeichnet:
die Anzahl der untersuchten Residuen,
die der Größe nach sortierten Residuen,
den Mittelwert der Residuen,
vom Stichprobenumfang abhängige Gewichtungskoeffizienten.
Die Teststatistik liegt zwischen 0 und 1. Werte nahe 1 sprechen für eine gute Übereinstimmung mit einer Normalverteilung. Die statistische Entscheidung erfolgt jedoch anhand des zugehörigen p-Werts.
Interpretation:
: Die Nullhypothese wird nicht verworfen. Es liegen keine statistisch signifikanten Hinweise auf eine Abweichung von der Normalverteilung vor.
: Die Nullhypothese wird verworfen. Die Residuen weichen statistisch signifikant von einer Normalverteilung ab.
Insbesondere bei großen Stichproben kann der Shapiro-Wilk-Test bereits auf geringe Abweichungen empfindlich reagieren. Daher wird ergänzend eine grafische Untersuchung vorgenommen.
1.2 Grafische Prüfung anhand eines Verteilungsdiagramms
Zusätzlich zum Shapiro-Wilk-Test wird ein Histogramm der Residuen erstellt. Dieses kann durch eine geschätzte Dichtekurve und eine theoretische Normalverteilungskurve ergänzt werden.
Bei annähernd normalverteilten Residuen ist eine symmetrische, glockenförmige Verteilung zu erwarten.
Abweichungen können sich beispielsweise durch folgende Merkmale zeigen:
eine ausgeprägte Schiefe der Verteilung,
mehrere Verteilungsgipfel,
ungewöhnlich schwere Verteilungsränder (Heavy Tails),
eine erhöhte Anzahl extremer Beobachtungen.
Gerade bei Finanzmarktrenditen können schwere Verteilungsränder und Extremwerte auftreten. Deshalb ist die gemeinsame Betrachtung des Shapiro-Wilk-Tests und der grafischen Verteilung besonders sinnvoll.
Eine Verletzung der Normalverteilungsannahme führt nicht automatisch dazu, dass die OLS-Koeffizienten verzerrt sind. Sie kann jedoch die Zuverlässigkeit klassischer Signifikanztests beeinträchtigen, insbesondere bei kleinen Stichproben.
2. Prüfung der Homoskedastizität
Die Homoskedastizität beschreibt die Annahme, dass die Varianz der Fehlerterme über die Beobachtungen hinweg konstant ist.
Bei einer Verletzung dieser Annahme liegt Heteroskedastizität vor. Die Fehlerstreuung hängt dann beispielsweise von den Ausprägungen der unabhängigen Variablen oder der Gruppenzugehörigkeit ab.
Da sich die statistischen Verfahren für Regression und ANOVA unterscheiden, erfolgt die Überprüfung getrennt.
2.1 Breusch-Pagan-Test bei der linearen Regression
Für die einfache und multiple lineare Regression wird der Breusch-Pagan-Test verwendet.
Dieser untersucht, ob die Varianz der Fehlerterme systematisch mit den unabhängigen Variablen zusammenhängt.
Die Hypothesen lauten:
Nullhypothese:
Die Fehlervarianz ist konstant. Es liegt Homoskedastizität vor.
Alternativhypothese:
Es liegt Heteroskedastizität vor.
Zur Berechnung des Breusch-Pagan-Tests werden zunächst die Residuen des geschätzten Regressionsmodells quadriert. Anschließend wird eine Hilfsregression durchgeführt, bei der die quadrierten Residuen durch die unabhängigen Variablen erklärt werden.
Die LM-Teststatistik (Lagrange Multiplier) wird in einer gebräuchlichen Variante berechnet als:
Dabei bezeichnet:
die Anzahl der Beobachtungen,
das Bestimmtheitsmaß der Hilfsregression.
Unter der Nullhypothese folgt die LM-Teststatistik asymptotisch einer Chi-Quadrat-Verteilung:
Dabei entspricht der Anzahl der in der Hilfsregression untersuchten unabhängigen Variablen ohne Konstante.
Der p-Wert ergibt sich aus der Chi-Quadrat-Verteilung:
Interpretation:
: Die Nullhypothese wird nicht verworfen. Es liegen keine ausreichenden Hinweise auf Heteroskedastizität vor.
: Die Nullhypothese wird verworfen. Es bestehen statistisch signifikante Hinweise auf Heteroskedastizität.
Ein großer LM-Wert führt bei gleicher Anzahl an Freiheitsgraden tendenziell zu einem kleineren p-Wert.
2.2 Levene-Test bei der ANOVA
Bei der klassischen einfaktoriellen ANOVA wird angenommen, dass die Fehlervarianzen innerhalb der untersuchten Gruppen gleich sind.
Diese Annahme wird mithilfe des Levene-Tests überprüft.
Die Hypothesen lauten:
Nullhypothese:
Die Varianzen aller Gruppen sind gleich.
Alternativhypothese:
Mindestens zwei Gruppen unterscheiden sich hinsichtlich ihrer Varianz.
Der Levene-Test untersucht die Streuung der Beobachtungen innerhalb der Gruppen. Hierzu werden die absoluten Abweichungen der einzelnen Werte von einem gruppenspezifischen Lageparameter betrachtet.
Die Teststatistik folgt unter geeigneten Voraussetzungen einer F-Verteilung beziehungsweise wird anhand dieser beurteilt.
Interpretation:
: Die Nullhypothese wird nicht verworfen. Es liegen keine signifikanten Hinweise auf unterschiedliche Gruppenvarianzen vor.
: Die Nullhypothese wird verworfen. Die Varianzen unterscheiden sich statistisch signifikant.
2.3 Klassische ANOVA oder Welch-ANOVA
Die klassische einfaktorielle ANOVA untersucht, ob sich die Mittelwerte mehrerer Gruppen statistisch signifikant unterscheiden.
Ihre Hypothesen lauten:
Nullhypothese:
Alle Gruppen besitzen denselben Erwartungswert.
Alternativhypothese:
Mindestens zwei Gruppenmittelwerte unterscheiden sich.
Die klassische ANOVA verwendet eine F-Teststatistik, die das Verhältnis der Variation zwischen den Gruppen zur Variation innerhalb der Gruppen beschreibt.
Die Welch-ANOVA untersucht dieselben Mittelwertshypothesen, berücksichtigt jedoch unterschiedliche Gruppenvarianzen und verwendet angepasste Freiheitsgrade.
Für die Auswahl des Verfahrens gilt:
Keine Hinweise auf ungleiche Varianzen: Die klassische ANOVA kann verwendet werden, sofern auch die weiteren Modellannahmen erfüllt sind.
Hinweise auf ungleiche Varianzen: Die Welch-ANOVA ist in der Regel besser geeignet, da sie keine Gleichheit der Gruppenvarianzen voraussetzt.
Der Levene-Test dient somit der Prüfung der Varianzhomogenität, während die klassische ANOVA und die Welch-ANOVA Unterschiede zwischen Gruppenmittelwerten untersuchen.
Wichtig ist, dass ein nicht signifikanter Levene-Test die Varianzgleichheit nicht beweist. Die Welch-ANOVA kann deshalb auch ohne vorherige Auswahl anhand des Levene-Tests als robustere Standardmethode verwendet werden.
Sowohl die klassische als auch die Welch-ANOVA setzen grundsätzlich unabhängige Beobachtungen voraus.
3. Prüfung der Unabhängigkeit
Bei der Untersuchung von Finanzzeitreihen ist die zeitliche Abhängigkeit der Beobachtungen beziehungsweise Fehlerterme besonders relevant.
Für die lineare Regression wird angenommen, dass die Fehlerterme unter den üblichen Voraussetzungen nicht systematisch über die Zeit korreliert sind. Auch bei der klassischen ANOVA ist die Unabhängigkeit der Beobachtungen eine zentrale Voraussetzung.
Zur Untersuchung zeitlicher Abhängigkeiten wird der Ljung-Box-Test eingesetzt. Dabei werden sowohl die Residuen als auch die quadrierten Residuen betrachtet.
3.1 Ljung-Box-Test auf den Residuen
Der Ljung-Box-Test untersucht, ob innerhalb einer festgelegten Anzahl von Zeitverzögerungen (Lags) statistisch signifikante Autokorrelationen vorliegen. Autokorrelation bedeutet, dass die Werte einer Zeitreihe mit ihren eigenen vergangenen Werten zusammenhängen.
Die Hypothesen lauten:
Nullhypothese:
Die Residuen weisen bis zum betrachteten Lag keine lineare Autokorrelation auf.
Alternativhypothese:
Mindestens eine Autokorrelation innerhalb der betrachteten Lags unterscheidet sich von null.
Die Ljung-Box-Teststatistik lautet:
Dabei bezeichnet:
die Ljung-Box-Teststatistik,
die Anzahl der Residuen,
die maximal untersuchte Anzahl an Lags,
die geschätzte Autokorrelation beim Lag .
Unter der Nullhypothese wird die Teststatistik näherungsweise anhand einer Chi-Quadrat-Verteilung beurteilt:
Die angegebene Verteilung mit Freiheitsgraden ist die grundlegende Referenz für eine unmodellierte Reihe. Bei Residuen aus geschätzten Zeitreihenmodellen können Anpassungen der Freiheitsgrade oder andere Verfahren erforderlich sein.
Interpretation:
: Die Nullhypothese wird nicht verworfen. Es liegen keine signifikanten Hinweise auf lineare Autokorrelation bis zum untersuchten Lag vor.
: Die Nullhypothese wird verworfen. Mindestens eine Autokorrelation innerhalb der untersuchten Lags ist statistisch signifikant.
Ein signifikanter Ljung-Box-Test deutet darauf hin, dass das Modell die zeitliche Struktur der Daten möglicherweise nicht vollständig erfasst.
3.2 Ljung-Box-Test auf den quadrierten Residuen
Zusätzlich wird der Ljung-Box-Test auf die quadrierten Residuen angewendet.
Während der Test auf den ursprünglichen Residuen lineare Autokorrelation untersucht, dient die Analyse der quadrierten Residuen dazu, zeitliche Abhängigkeiten in der Fehlerstreuung zu erkennen.
Dies ist insbesondere bei Finanzmarktrenditen relevant, da Phasen hoher und niedriger Volatilität häufig zeitlich gehäuft auftreten. Dieses Phänomen wird als Volatilitätsclustering bezeichnet.
Die Hypothesen lauten:
Nullhypothese:
Die quadrierten Residuen weisen bis zum betrachteten Lag keine Autokorrelation auf.
Alternativhypothese:
Mindestens eine Autokorrelation der quadrierten Residuen unterscheidet sich von null.
Die Teststatistik wird analog zum Ljung-Box-Test auf den ursprünglichen Residuen berechnet, wobei die Autokorrelationen der quadrierten Residuen verwendet werden.
Interpretation:
: Die Nullhypothese wird nicht verworfen. Es liegen keine signifikanten Hinweise auf Autokorrelation der quadrierten Residuen vor.
: Die Nullhypothese wird verworfen. Es bestehen Hinweise auf zeitliche Abhängigkeiten in den quadrierten Residuen und damit möglicherweise auf Volatilitätsclustering beziehungsweise ARCH-Effekte.
Ein signifikanter Test auf den quadrierten Residuen kann somit auf eine zeitlich veränderliche bedingte Varianz hindeuten. Für eine gezielte Untersuchung von ARCH-Effekten kann ergänzend ein ARCH-LM-Test durchgeführt werden.
3.3 Bedeutung für die Modellinterpretation
Die beiden Ljung-Box-Tests untersuchen unterschiedliche Formen zeitlicher Abhängigkeit:
Untersuchungsgröße Untersuchte Eigenschaft Interpretation bei Residuen Lineare Autokorrelation Hinweise auf zeitliche Abhängigkeit der Residuen Quadrierte Residuen Autokorrelation der quadrierten Fehler Hinweise auf Volatilitätsclustering oder ARCH-Effekte
Ein nicht signifikanter Ljung-Box-Test beweist keine vollständige statistische Unabhängigkeit, da beispielsweise nichtlineare Abhängigkeiten bestehen können.
Bei festgestellter Autokorrelation müssen die statistischen Schlussfolgerungen entsprechend angepasst werden. Für Regressionsmodelle können beispielsweise HAC-Standardfehler nach Newey-West eingesetzt werden. Bei zeitlich abhängigen Beobachtungen ist eine klassische oder Welch-ANOVA hingegen nicht ohne Weiteres geeignet.
Die Auswahl der maximalen Lag-Anzahl sollte vor der Interpretation festgelegt und anhand der Datenfrequenz sowie des Untersuchungsziels begründet werden.
⸻
4. Prüfung der Linearität
Die lineare Regression setzt voraus, dass der bedingte Erwartungswert der abhängigen Variable durch eine lineare Funktion der Regressionsparameter und der berücksichtigten erklärenden Variablen angemessen beschrieben werden kann.
Bei der einfachen linearen Regression kann die Linearitätsannahme durch ein Streudiagramm (Scatterplot) der abhängigen und der unabhängigen Variable untersucht werden.
Hierbei werden die beobachteten Wertepaare grafisch dargestellt und durch eine geschätzte Regressionsgerade ergänzt.
Ein annähernd linearer Zusammenhang ist plausibel, wenn die Punktwolke keine ausgeprägte systematische Krümmung erkennen lässt.
Bei der multiplen linearen Regression ist die Betrachtung einzelner Streudiagramme nur eingeschränkt aussagekräftig, da die übrigen unabhängigen Variablen nicht konstant gehalten werden. Daher können ergänzend partielle Residuenplots oder Residuen-gegen-vorhergesagte-Werte-Diagramme verwendet werden.
4.1 Grafische Interpretation
Bei der grafischen Prüfung wird insbesondere auf folgende Muster geachtet:
Annähernd lineares Muster: Der Zusammenhang kann plausibel durch eine lineare Funktion beschrieben werden.
Systematische Krümmung: Es bestehen Hinweise darauf, dass die lineare Modellspezifikation nicht ausreichend ist.
Keine erkennbare Struktur: Es ist kein eindeutiger Zusammenhang sichtbar; dies schließt einen bedingten linearen Zusammenhang jedoch nicht aus.
Einzelne extreme Beobachtungen: Ausreißer können die geschätzte Regressionsgerade beeinflussen.
Da die Linearität hier ausschließlich grafisch untersucht wird, werden keine formalen Null- und Alternativhypothesen formuliert und keine p-Werte berechnet.
Bei deutlichen Abweichungen von der Linearitätsannahme kann eine Anpassung der Modellspezifikation erforderlich sein, beispielsweise durch die Aufnahme nichtlinearer Terme.
Für die einfaktorielle ANOVA ist keine gesonderte Prüfung eines linearen Zusammenhangs zwischen metrischen Variablen erforderlich, da die erklärende Variable aus Gruppenzugehörigkeiten besteht.
⸻
5. Prüfung der Multikollinearität
Die Prüfung der Multikollinearität ist insbesondere bei der multiplen linearen Regression relevant, da mehrere unabhängige Variablen gleichzeitig in das Regressionsmodell aufgenommen werden.
Multikollinearität liegt vor, wenn zwischen den unabhängigen Variablen starke lineare Zusammenhänge bestehen.
Eine hohe Multikollinearität kann dazu führen, dass die Regressionskoeffizienten nur unpräzise geschätzt werden und ihre Standardfehler ansteigen. Dadurch kann die statistische Signifikanz einzelner Einflussgrößen beeinträchtigt werden.
Zur Untersuchung wird der Variance Inflation Factor (VIF) verwendet.
5.1 Berechnung des Variance Inflation Factor
Der VIF wird für jede unabhängige Variable separat berechnet:
Dabei bezeichnet:
den Variance Inflation Factor der unabhängigen Variable ,
das Bestimmtheitsmaß einer Hilfsregression, in der durch alle übrigen unabhängigen Variablen erklärt wird.
Ein hoher Wert von bedeutet, dass sich die betreffende unabhängige Variable stark durch die übrigen Variablen erklären lässt. In diesem Fall steigt auch der VIF.
5.2 Interpretation der VIF-Werte
Für die Interpretation werden häufig folgende Richtwerte verwendet:
VIF-Wert Interpretation Keine lineare Abhängigkeit von den übrigen unabhängigen Variablen In vielen Anwendungen unproblematische Multikollinearität Hinweise auf möglicherweise problematische Multikollinearität Starke Hinweise auf problematische Multikollinearität
Diese Grenzwerte sind als Orientierungshilfen zu verstehen und stellen keine allgemeingültigen statistischen Entscheidungsgrenzen dar.
Im Gegensatz zu den zuvor beschriebenen Hypothesentests handelt es sich beim VIF um ein Diagnosemaß. Daher werden keine klassischen Null- und Alternativhypothesen formuliert und keine p-Werte berechnet.
5.3 Umgang mit Multikollinearität
Bei erhöhten VIF-Werten sollte geprüft werden, ob mehrere unabhängige Variablen ähnliche Informationen enthalten.
Mögliche Maßnahmen sind:
der begründete Ausschluss einzelner stark korrelierter Variablen,
die Zusammenfassung inhaltlich ähnlicher Variablen,
die Verwendung alternativer Schätzverfahren wie der Ridge-Regression.
Die Auswahl geeigneter Maßnahmen sollte sich an der Forschungsfrage und der theoretischen Bedeutung der Variablen orientieren.
Eine hohe Multikollinearität führt bei ansonsten erfüllten OLS-Annahmen nicht zwangsläufig zu verzerrten Koeffizientenschätzungen, kann jedoch deren Präzision erheblich reduzieren.
Bei einer einfachen linearen Regression mit nur einer unabhängigen Variable ist eine Prüfung der Multikollinearität nicht erforderlich.
⸻
6. Zusammenfassung der statistischen Modellüberprüfung
Die nachfolgende Tabelle fasst die verwendeten statistischen Verfahren, ihre Anwendungsbereiche und die jeweiligen Entscheidungskriterien zusammen.
| Modellannahme | Verfahren | Anwendungsbereich | Kennwert | Entscheidung / Interpretation |
|---|---|---|---|---|
| Normalverteilung | Shapiro-Wilk-Test | Regression und ANOVA | , p-Wert | : Signifikante Abweichung von der Normalverteilung |
| Normalverteilung | Histogramm der Residuen | Regression und ANOVA | Grafische Beurteilung | Untersuchung von Schiefe, Ausreißern und Verteilungsform |
| Homoskedastizität | Breusch-Pagan-Test | Einfache und multiple Regression | LM, , p-Wert | : Hinweise auf Heteroskedastizität |
| Varianzhomogenität | Levene-Test | ANOVA | F-Statistik, p-Wert | : Hinweise auf ungleiche Gruppenvarianzen |
| Mittelwertunterschiede | Klassische ANOVA / Welch-ANOVA | Gruppenvergleiche | F-Statistik, p-Wert | : Mindestens zwei Gruppenmittelwerte unterscheiden sich |
| Lineare Autokorrelation | Ljung-Box-Test auf | Zeitlich geordnete Residuen | , p-Wert | : Hinweise auf Autokorrelation |
| Volatilitätsclustering | Ljung-Box-Test auf | Zeitlich geordnete Residuen | , p-Wert | : Hinweise auf zeitliche Abhängigkeit der quadrierten Residuen |
| Linearität | Scatterplot / Residuenplot | Einfache und multiple Regression | Grafische Beurteilung | Untersuchung systematischer nichtlinearer Muster |
| Multikollinearität | Variance Inflation Factor (VIF) | Multiple Regression | VIF | : Nähere Prüfung; : Starke Hinweise auf Multikollinearität |
Hinweis: Für die statistischen Hypothesentests wird ein Signifikanzniveau von verwendet. Bei wird die jeweilige Nullhypothese verworfen. Bei kann die Nullhypothese nicht verworfen werden. Dies stellt jedoch keinen endgültigen Nachweis für die Gültigkeit der jeweiligen Modellannahme dar.
Die Kombination aus statistischen Hypothesentests und grafischen Diagnoseverfahren ermöglicht eine systematische Beurteilung der Modellannahmen. Dabei müssen die Ergebnisse stets im Zusammenhang mit der Stichprobengröße, den Eigenschaften der untersuchten Finanzzeitreihen und dem jeweiligen Modell interpretiert werden.
Insbesondere bei Finanzmarktdaten können Autokorrelation, Heteroskedastizität und Volatilitätsclustering auftreten. Werden entsprechende Verletzungen der Modellannahmen festgestellt, müssen die Schätz- und Inferenzverfahren gegebenenfalls angepasst werden, um belastbare statistische Schlussfolgerungen zu ermöglichen.
Modellgüte und statistische Signifikanz
Zur Beurteilung eines statistischen Modells werden das Bestimmtheitsmaß, die Standardfehler und der F-Test herangezogen. Sie beschreiben unterschiedliche Aspekte der Modellgüte und der statistischen Unsicherheit.
1. Bestimmtheitsmaß ()
Das Bestimmtheitsmaß gibt an, welcher Anteil der Streuung der abhängigen Variable durch das Regressionsmodell erklärt wird.
Ein Wert von bedeutet beispielsweise, dass das Modell 70 % der beobachteten Streuung erklärt.
Bei der multiplen linearen Regression wird zusätzlich das adjustierte Bestimmtheitsmaß betrachtet. Es berücksichtigt die Anzahl der erklärenden Variablen und eignet sich daher besser zum Vergleich unterschiedlich komplexer Modelle.
2. Standardfehler
Standardfehler beschreiben die Unsicherheit statistischer Schätzungen. Dabei ist zwischen zwei Größen zu unterscheiden:
Standardfehler der Regressionskoeffizienten: Beschreiben die Schätzunsicherheit der einzelnen Koeffizienten . Sie werden für t-Tests und Konfidenzintervalle verwendet.
Residualstandardfehler: Beschreibt die typische Größe der Abweichungen zwischen beobachteten und vorhergesagten Werten.
Der Residualstandardfehler wird bei einer multiplen Regression mit erklärenden Variablen und einem Achsenabschnitt berechnet als:
Ein kleinerer Residualstandardfehler weist bei gleicher Zielvariable und vergleichbaren Daten auf eine geringere verbleibende Streuung hin.
3. F-Test
Der F-Test untersucht, ob ein statistisches Modell insgesamt einen signifikanten Erklärungsbeitrag liefert.
Multiple lineare Regression:
Ein p-Wert bedeutet, dass das Regressionsmodell insgesamt statistisch signifikant ist. Daraus folgt jedoch nicht, dass jeder einzelne Regressionskoeffizient signifikant ist.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

from scipy.stats import shapiro, norm
from statsmodels.stats.diagnostic import het_breuschpagan, acorr_ljungbox
from statsmodels.stats.outliers_influence import variance_inflation_factor
from IPython.display import display


# 1. Datenaufbereitung

alpha = 0.05  # Signifikanzniveau
lags = [5, 10, 20]  # Untersuchte Zeitverzögerungen

df = pd.read_csv("../../Data/log_returns.csv")  # Datensatz einlesen
df["Datum"] = pd.to_datetime(df["Datum"])  # Datum konvertieren
df = df.sort_values("Datum")  # Beobachtungen chronologisch sortieren

y_variable = "Aktie"  # Abhängige Variable
x_variables = ["DAX", "S&P500", "NASDAQ"]  # Unabhängige Variablen

df_reg = df[[y_variable] + x_variables].dropna().copy()  # Fehlende Werte entfernen

Y = df_reg[y_variable]  # Abhängige Variable festlegen
X = df_reg[x_variables]  # Unabhängige Variablen festlegen
X = sm.add_constant(X, has_constant="add")  # Konstante hinzufügen

print(f"Anzahl der Beobachtungen: {len(df_reg)}")


# 2. Multiple lineare Regression

modell = sm.OLS(Y, X).fit()  # OLS-Regression durchführen

print("\nMULTIPLE LINEARE REGRESSION")
print(modell.summary())  # Regressionsergebnisse ausgeben

y_hat = modell.fittedvalues  # Vorhergesagte Werte
residuen = modell.resid  # Residuen
residuen_quadriert = residuen**2  # Quadrierte Residuen

koeffizienten = pd.DataFrame({
    "Koeffizient": modell.params,
    "Standardfehler": modell.bse,
    "t-Wert": modell.tvalues,
    "p-Wert": modell.pvalues,
    "Konfidenzintervall unten": modell.conf_int()[0],
    "Konfidenzintervall oben": modell.conf_int()[1]
})  # Ergebnisse der Regressionskoeffizienten zusammenfassen

print("\nREGRESSIONSKOEFFIZIENTEN")
display(koeffizienten.round(6))

print(f"R²: {modell.rsquared:.4f}")  # Bestimmtheitsmaß
print(f"Adjustiertes R²: {modell.rsquared_adj:.4f}")  # Adjustiertes Bestimmtheitsmaß
print(f"F-Statistik: {modell.fvalue:.4f}")  # F-Teststatistik
print(f"F-p-Wert: {modell.f_pvalue:.6g}")  # p-Wert des Gesamtmodells


# 3. Normalverteilung: Shapiro-Wilk-Test

shapiro_stat, shapiro_p = shapiro(residuen)  # Shapiro-Wilk-Test durchführen

print("\nSHAPIRO-WILK-TEST")
print(f"W-Statistik: {shapiro_stat:.4f}")
print(f"p-Wert: {shapiro_p:.6g}")

if shapiro_p <= alpha:
    print("Signifikante Abweichung von der Normalverteilung.")
else:
    print("Keine signifikante Abweichung von der Normalverteilung nachgewiesen.")


plt.figure(figsize=(10, 5))  # Diagrammgröße festlegen

sns.histplot(
    residuen,
    bins=30,
    kde=True,
    stat="density",
    label="Residuen"
)  # Histogramm der Residuen erstellen

x_norm = np.linspace(residuen.min(), residuen.max(), 200)  # Wertebereich festlegen

y_norm = norm.pdf(
    x_norm,
    loc=residuen.mean(),
    scale=residuen.std(ddof=1)
)  # Theoretische Normalverteilung berechnen

plt.plot(x_norm, y_norm, color="red", linestyle="--", label="Normalverteilung")  # Normalverteilung darstellen
plt.title("Verteilung der Residuen")
plt.xlabel("Residuen")
plt.ylabel("Dichte")
plt.legend()
plt.grid(alpha=0.3)
plt.show()


# 4. Homoskedastizität: Breusch-Pagan-Test

bp_lm, bp_lm_p, bp_f, bp_f_p = het_breuschpagan(
    residuen,
    X
)  # Breusch-Pagan-Test durchführen

bp_df = X.shape[1] - 1  # Freiheitsgrade der Chi-Quadrat-Verteilung

print("\nBREUSCH-PAGAN-TEST")
print(f"LM-Statistik: {bp_lm:.4f}")
print(f"Freiheitsgrade: {bp_df}")
print(f"LM-p-Wert: {bp_lm_p:.6g}")
print(f"F-Statistik: {bp_f:.4f}")
print(f"F-p-Wert: {bp_f_p:.6g}")

if bp_lm_p <= alpha:
    print("Signifikante Hinweise auf Heteroskedastizität.")
else:
    print("Keine signifikante Heteroskedastizität nachgewiesen.")


plt.figure(figsize=(10, 5))  # Diagrammgröße festlegen
plt.scatter(y_hat, residuen, alpha=0.6)  # Residuen gegen vorhergesagte Werte darstellen
plt.axhline(0, color="red", linestyle="--")  # Nulllinie einzeichnen
plt.title("Residuen gegen vorhergesagte Werte")
plt.xlabel("Vorhergesagte Werte")
plt.ylabel("Residuen")
plt.grid(alpha=0.3)
plt.show()


# 5. Unabhängigkeit: Ljung-Box-Test auf Residuen

if len(residuen) <= max(lags):
    raise ValueError("Für die gewählten Ljung-Box-Lags sind zu wenige Beobachtungen vorhanden.")

lb_residuen = acorr_ljungbox(
    residuen,
    lags=lags,
    return_df=True
)  # Ljung-Box-Test auf Residuen durchführen

print("\nLJUNG-BOX-TEST: RESIDUEN")
display(lb_residuen.round(6))

for lag, row in lb_residuen.iterrows():
    p = row["lb_pvalue"]  # p-Wert des jeweiligen Lags

    if p <= alpha:
        ergebnis = "Signifikante Hinweise auf Autokorrelation"
    else:
        ergebnis = "Keine signifikante Autokorrelation nachgewiesen"

    print(f"Lag {lag}: p = {p:.6g} | {ergebnis}")


# 6. Volatilitätsclustering: Ljung-Box-Test auf quadrierte Residuen

lb_quadriert = acorr_ljungbox(
    residuen_quadriert,
    lags=lags,
    return_df=True
)  # Ljung-Box-Test auf quadrierte Residuen durchführen

print("\nLJUNG-BOX-TEST: QUADRIERTE RESIDUEN")
display(lb_quadriert.round(6))

for lag, row in lb_quadriert.iterrows():
    p = row["lb_pvalue"]  # p-Wert des jeweiligen Lags

    if p <= alpha:
        ergebnis = "Signifikante Hinweise auf Volatilitätsclustering"
    else:
        ergebnis = "Kein signifikantes Volatilitätsclustering nachgewiesen"

    print(f"Lag {lag}: p = {p:.6g} | {ergebnis}")


# 7. Linearität: Scatterplots

for variable in x_variables:

    plt.figure(figsize=(9, 5))  # Diagrammgröße festlegen

    sns.regplot(
        x=df_reg[variable],
        y=Y,
        scatter_kws={"alpha": 0.5},
        line_kws={"color": "red"}
    )  # Scatterplot mit Regressionsgerade erstellen

    plt.title(f"Zusammenhang zwischen {variable} und {y_variable}")
    plt.xlabel(variable)
    plt.ylabel(y_variable)
    plt.grid(alpha=0.3)
    plt.show()


# 8. Linearität: Partielle Residuenplots

fig = sm.graphics.plot_ccpr_grid(modell)  # Partielle Residuenplots erstellen
fig.set_size_inches(12, 8)  # Diagrammgröße festlegen
plt.tight_layout()
plt.show()


# 9. Multikollinearität: Variance Inflation Factor

vif_tabelle = pd.DataFrame({
    "Variable": x_variables,
    "VIF": [
        variance_inflation_factor(X.values, X.columns.get_loc(variable))
        for variable in x_variables
    ]
})  # VIF-Werte berechnen


def interpretiere_vif(vif):
    if vif < 5:
        return "Unauffällig"
    elif vif < 10:
        return "Erhöhte Multikollinearität"
    else:
        return "Starke Multikollinearität"


vif_tabelle["Interpretation"] = vif_tabelle["VIF"].apply(interpretiere_vif)  # VIF-Werte interpretieren

print("\nVARIANCE INFLATION FACTOR")
display(vif_tabelle.round(4))


# 10. Modellgüte
print("\nMODELLGÜTE DER MULTIPLEN LINEAREN REGRESSION")

# Bestimmtheitsmaß
print("\nBESTIMMTHEITSMASS")
print(f"R²: {modell.rsquared:.4f}")  # Bestimmtheitsmaß
print(f"Adjustiertes R²: {modell.rsquared_adj:.4f}")  # Adjustiertes Bestimmtheitsmaß

# Standardfehler
print("\nSTANDARDFEHLER")
residualstandardfehler = np.sqrt(modell.mse_resid)  # Residualstandardfehler berechnen
print(f"Residualstandardfehler: {residualstandardfehler:.6f}")  # Standardfehler der Regression

standardfehler_tabelle = pd.DataFrame({
    "Variable": modell.params.index,
    "Koeffizient": modell.params.values,
    "Standardfehler": modell.bse.values
})  # Standardfehler der Regressionskoeffizienten zusammenstellen

display(standardfehler_tabelle.round(6))


# F-Test
print("\nF-TEST DES GESAMTMODELLS")
print(f"F-Statistik: {modell.fvalue:.4f}")  # F-Teststatistik
print(f"p-Wert: {modell.f_pvalue:.6g}")  # p-Wert des F-Tests
print(f"Freiheitsgrade: {int(modell.df_model)} und {int(modell.df_resid)}")  # Freiheitsgrade

if modell.f_pvalue <= alpha:
    print("Das Regressionsmodell ist insgesamt statistisch signifikant.")
else:
    print("Das Regressionsmodell ist insgesamt nicht statistisch signifikant.")
Anzahl der Beobachtungen: 260
MULTIPLE LINEARE REGRESSION
                            OLS Regression Results
==============================================================================
Dep. Variable:                  Aktie   R-squared:                       0.592
Model:                            OLS   Adj. R-squared:                  0.588
Method:                 Least Squares   F-statistic:                     124.0
Date:                Tue, 27 Oct 2026   Prob (F-statistic):           1.26e-49
Time:                        13:12:50   Log-Likelihood:                 868.98
No. Observations:                 260   AIC:                            -1730.
Df Residuals:                     256   BIC:                            -1716.
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          0.0005      0.001      0.929      0.354      -0.001       0.002
DAX            0.3528      0.081      4.368      0.000       0.194       0.512
S&P500         0.4752      0.100      4.735      0.000       0.278       0.673
NASDAQ         0.3999      0.073      5.458      0.000       0.256       0.544
==============================================================================
Omnibus:                        1.682   Durbin-Watson:                   2.152
Prob(Omnibus):                  0.431   Jarque-Bera (JB):                1.462
Skew:                           0.023   Prob(JB):                        0.481
Kurtosis:                       2.636   Cond. No.                         214.
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.

REGRESSIONSKOEFFIZIENTEN
R²: 0.5924
Adjustiertes R²: 0.5877
F-Statistik: 124.0420
F-p-Wert: 1.25754e-49

SHAPIRO-WILK-TEST
W-Statistik: 0.9939
p-Wert: 0.370375
Keine signifikante Abweichung von der Normalverteilung nachgewiesen.
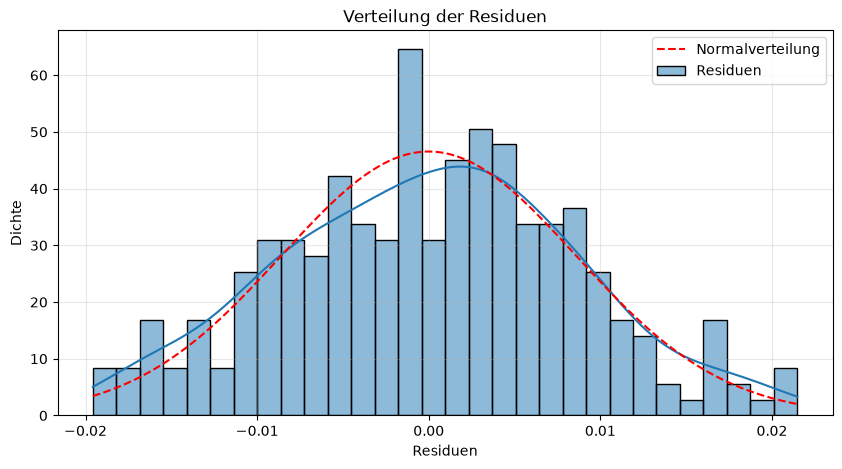
BREUSCH-PAGAN-TEST
LM-Statistik: 9.5846
Freiheitsgrade: 3
LM-p-Wert: 0.0224478
F-Statistik: 3.2661
F-p-Wert: 0.0219455
Signifikante Hinweise auf Heteroskedastizität.

LJUNG-BOX-TEST: RESIDUEN
Lag 5: p = 0.162553 | Keine signifikante Autokorrelation nachgewiesen
Lag 10: p = 0.0602149 | Keine signifikante Autokorrelation nachgewiesen
Lag 20: p = 0.0698196 | Keine signifikante Autokorrelation nachgewiesen

LJUNG-BOX-TEST: QUADRIERTE RESIDUEN
Lag 5: p = 0.709387 | Kein signifikantes Volatilitätsclustering nachgewiesen
Lag 10: p = 0.181778 | Kein signifikantes Volatilitätsclustering nachgewiesen
Lag 20: p = 0.197978 | Kein signifikantes Volatilitätsclustering nachgewiesen


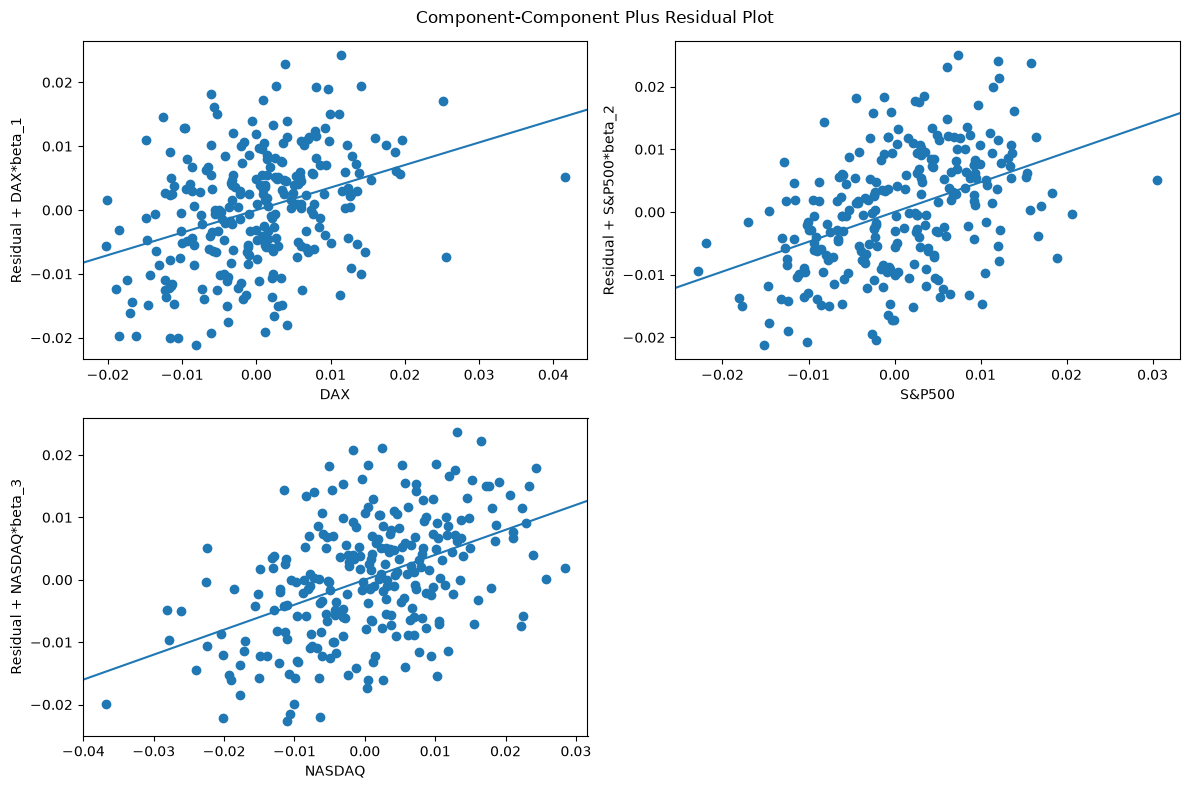
VARIANCE INFLATION FACTOR
MODELLGÜTE DER MULTIPLEN LINEAREN REGRESSION

BESTIMMTHEITSMASS
R²: 0.5924
Adjustiertes R²: 0.5877

STANDARDFEHLER
Residualstandardfehler: 0.008622
F-TEST DES GESAMTMODELLS
F-Statistik: 124.0420
p-Wert: 1.25754e-49
Freiheitsgrade: 3 und 256
Das Regressionsmodell ist insgesamt statistisch signifikant.
- Bortz, J., & Schuster, C. (2011). Statistik für Human- und Sozialwissenschaftler (7. Aufl.). Springer-Verlag.
- Pruscha, H. (2000). Vorlesungen über Mathematische Statistik -. Springer-Verlag.
- Stock, J. H., & Watson, M. W. (2020). Introduction to Econometrics (4th ed.). Pearson Education Limited.
- Kutner, M. H. (2005). Applied Linear Statistical Models. McGraw-Hill Irwin. https://books.google.de/books?id=0xqCAAAACAAJ
- Hamilton, J. D. (1994). Time Series Analysis. Princeton University Press.
- Enders, W. (2015). Applied Econometric Time Series (4th ed.). Wiley.
- Campbell, J. Y., Lo, A. W., & MacKinlay, A. C. (1997). The Econometrics of Financial Markets. Princeton University Press.
- Shumway, R. H., & Stoffer, D. S. (2017). Time Series Analysis and Its Applications (4th ed.). Springer.